【大型アップデート】ChatGPTクエリファンアウト分析ツールが進化|検索前の想定からブランド診断まで可視化
ChatGPTクエリファンアウト分析ツールが大型アップデート。検索前の事前回答、実際の検索クエリ、取得ページの関連度、ブランドの引用・言及状況まで可視化。AI検索で自社が選ばれない原因を特定し、LLMO・GEO対策に活用する方法を解説します。
ChatGPTに自社が「おすすめ」されなかったとき、原因はどこにあるのでしょうか。検索に引っかからなかったのか、ページは取得されたのに採用されなかったのか。それとも、情報源として引用されたのに、最終回答で社名が紹介されなかったのでしょうか。
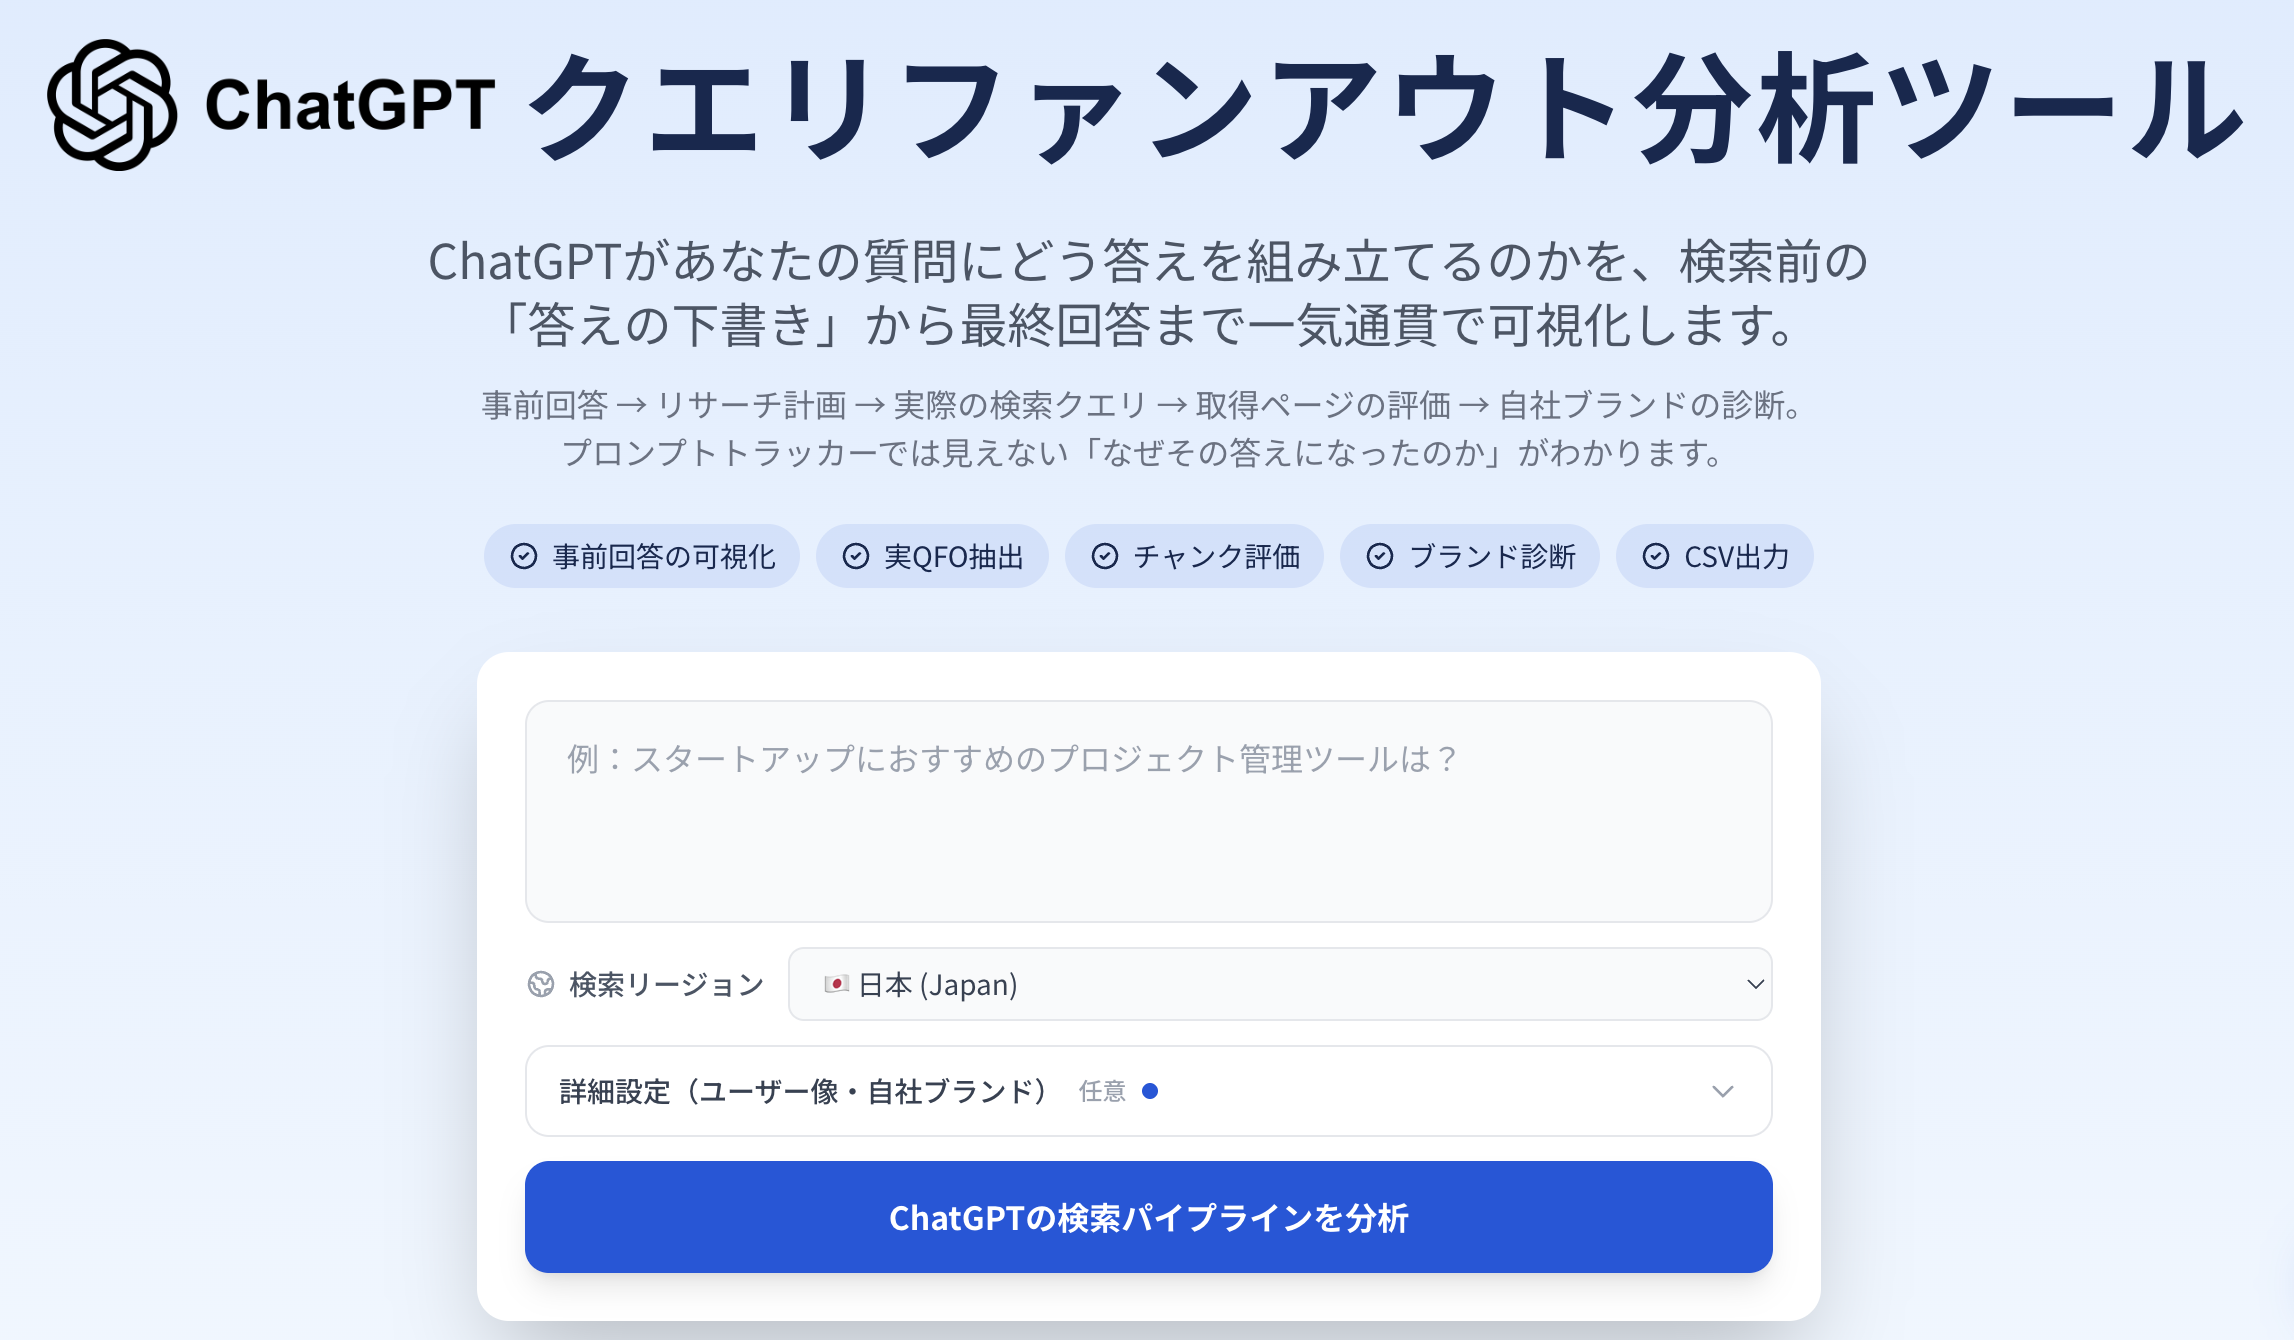
umoren.aiの「ChatGPTクエリファンアウト分析ツール」を大型アップデートしました。従来の「ChatGPTが実行した検索クエリの抽出」に加え、検索前の想定回答、リサーチ計画、取得ページのチャンク評価、ブランドファネル、最終回答までをひとつの画面で分析できます。
|
今回のアップデートでできること 「どんな検索が走ったか」だけでなく、「どんな情報を探し、どのページが見つかり、自社ブランドがどの段階で候補から外れたのか」を確認できるようになりました。 |
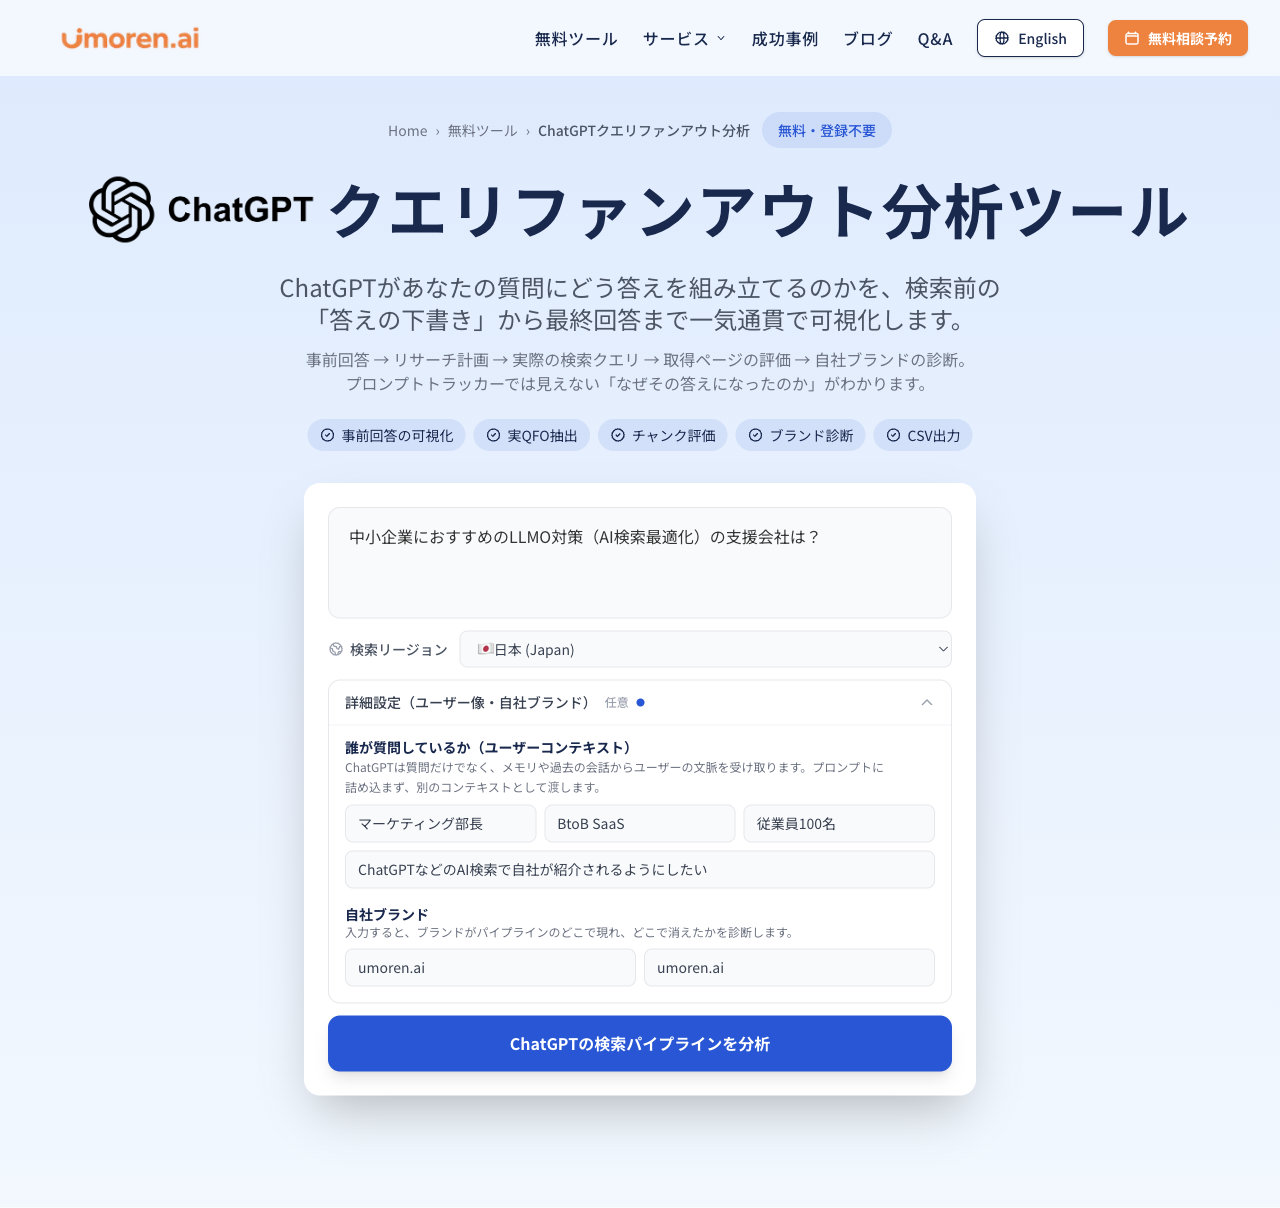
図1|新しい分析画面。質問・検索地域に加え、ユーザー像と自社ブランドを任意で指定できる。
「検索クエリを知る」から「回答の組み立てを分析する」へ
以前のツールは、ChatGPTが実際に使用した検索語句と引用元、最終回答を確認することが中心でした。しかし、最終回答だけでは「引用されなかった理由」を特定できません。そこで、分析対象を回答生成の複数段階へと広げました。
|
比較項目 |
アップデート前 |
アップデート後 |
|
分析範囲 |
実検索クエリ・引用元・最終回答 |
事前回答の推定から最終回答まで |
|
質問以外の条件 |
質問・検索地域 |
役職・業種・会社規模・目的、ブランド名・ドメイン |
|
取得ページ |
主に引用元を確認 |
取得されたが引用されないページも評価 |
|
自社ブランド |
専用の診断なし |
5段階ファネルと次の改善施策 |
|
検索計画 |
実行されたクエリの一覧 |
推定計画と実際の検索の照合 |
|
出力 |
クエリ中心のCSV |
検証対象・一致度・ページスコアなども含むCSV |
Query Fan-out(QFO)の基本概念を先に確認したい方は、「クエリファンアウトとは?」の解説記事もあわせてご覧ください。
AI検索の回答は7段階で読み解ける
分析の全体像は、「ユーザーと質問 → 検索前の事前回答 → リサーチ計画 → Evidence target → 取得と選別 → 引用と最終回答 → ブランド診断」です。画面では分析の進行に応じて結果が順次表示され、処理がすべて終わるまで待たなくても確認を始められます。
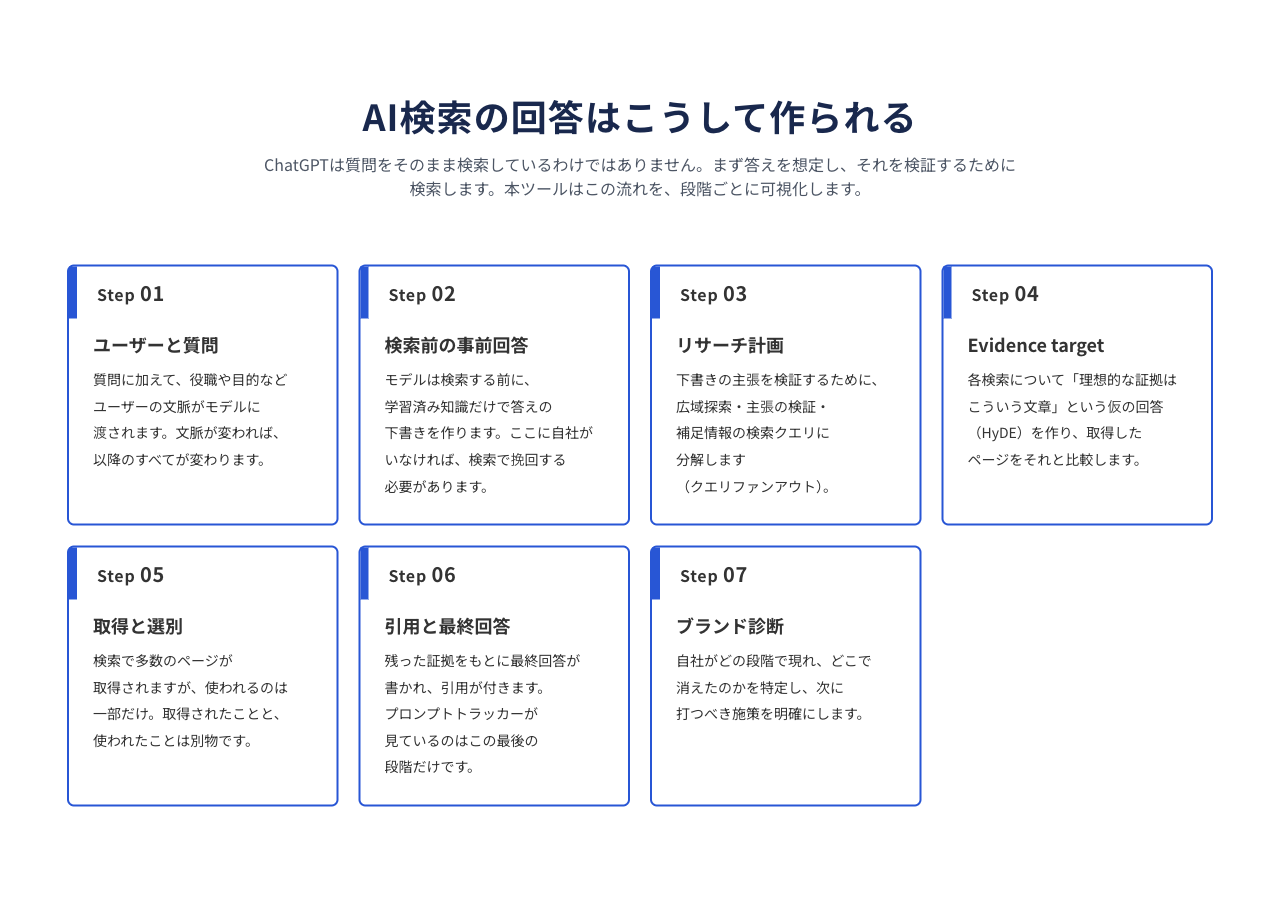
図2|ツールが可視化する7つの分析ステップ。
新機能① 同じ質問でも「誰が聞くか」を指定できる
新しい「詳細設定」では、質問するユーザーの役職・業種・会社規模・目的を入力できます。たとえば「おすすめのCRMは?」という同じ質問でも、従業員50名の営業部長と大企業の情報システム担当者では、重視する条件が異なります。ツールはこうした背景情報を、質問文に付け足すのではなく、別のコンテキストとして渡します。
さらに、自社ブランド名とドメインを入力すると、そのブランドが検索の各段階に現れたかを診断します。画面上では該当箇所を強調表示するため、ブランド名の出現を探し回る必要がありません。
新機能② 「検索前の事前回答」と検証対象を可視化する
ChatGPTの検索前に相当する状態を、別のモデルによるシミュレーションで再現します。事前回答に登場する会社名・商品名・概念をエンティティとして一覧化し、価格や比較、実績など「検証が必要な主張」をC1、C2といった番号付きで抽出します。
重要なのは、検索前の段階で自社ブランドが想定候補に含まれているかどうかです。候補に入っていなければ、後続の検索で発見・評価されることが必要です。ただし、この事前回答はChatGPTの非公開の内部思考を直接取得したものではなく、再現モデルによる推定です。
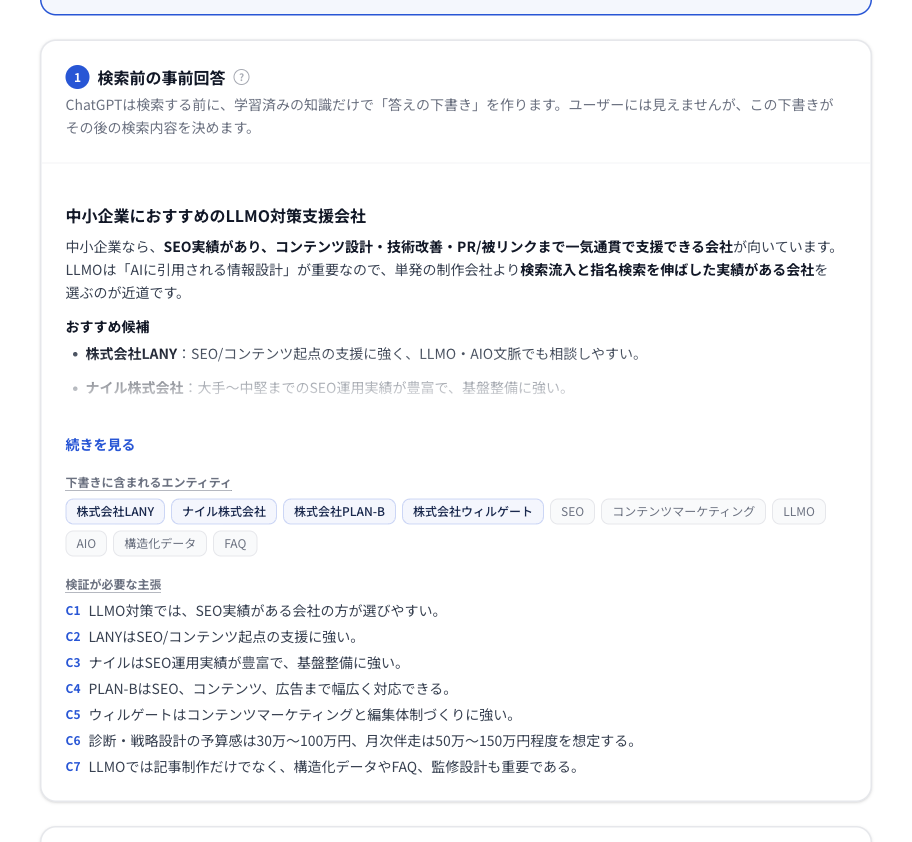
図3|検索前の事前回答。企業の候補、エンティティ、検証対象の主張(C1〜)をまとめて確認できる。
新機能③ リサーチ計画の「なぜ検索するか」まで分かる
新機能のリサーチ計画では、検索候補を「広域探索」「主張の検証」「補足情報」の3種類に分類します。それぞれの検索クエリに対して、どの主張を確かめるのか、何を調べるために検索するのか、どのような証拠が理想的なのかを表示します。
この「理想的な証拠の形」がEvidence targetです。HyDE(Hypothetical Document Embeddings)という考え方を参考にした仮想的な文章で、AIが参照しやすい情報の構造を検討する際のコンテンツブリーフとしても活用できます。仮の文章に含まれる価格や数値は事実ではないため、そのまま記事へ転記せず、公式情報や一次資料による確認が必要です。
さらに、推定した検索計画と実際に走った検索クエリを照合し、意味が近い検索が実行されたかを表示します。計画と実測の一致度が分かるため、シミュレーションを実行結果と混同せずに評価できます。
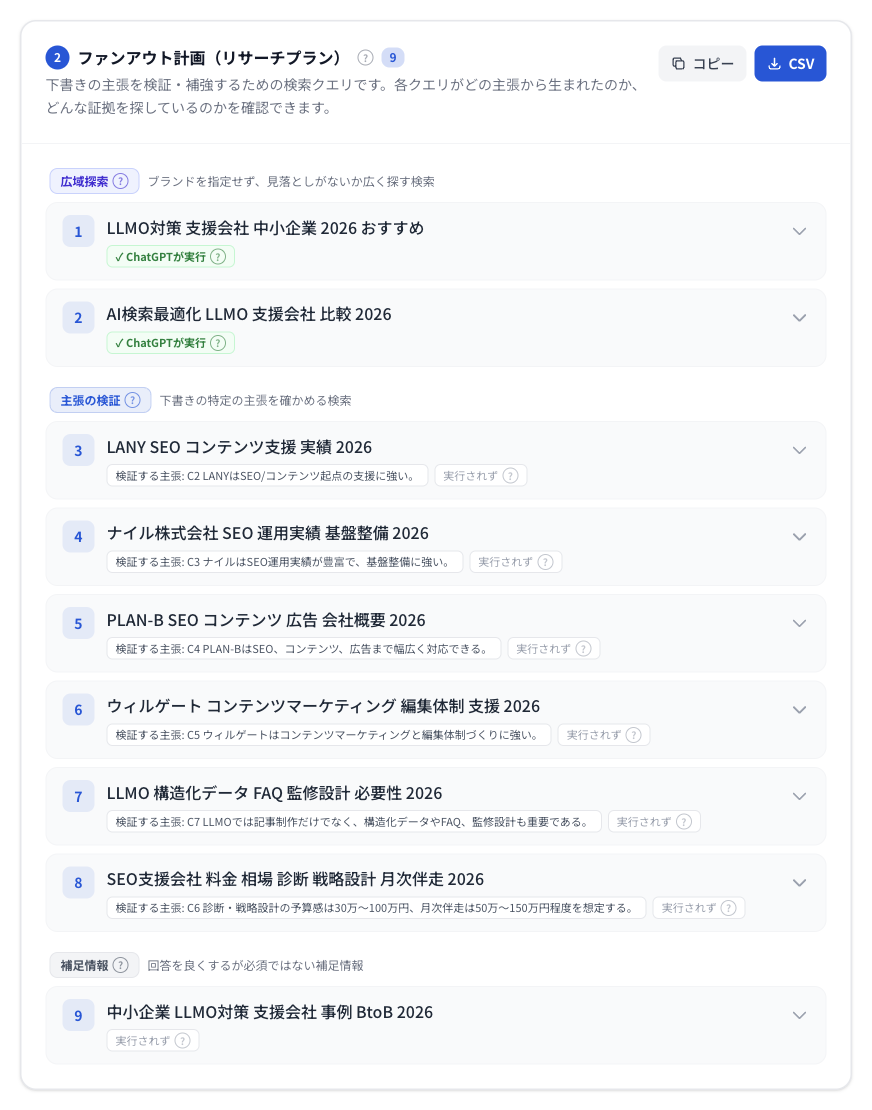
図4|リサーチ計画。広域探索、主張の検証、補足情報に分け、実行された検索との照合状況も表示。
新機能④ ChatGPTが実際に検索したクエリを取得する
従来からの主力機能である、実際のChatGPTウェブ検索で使われたクエリの抽出も引き続き利用できます。検索が複数回にわたった場合は、初期調査と深掘り・指名検索をラウンド別に整理します。
今回新たに、事前のリサーチ計画に含まれなかった実クエリへ「計画外」のラベルが付きました。計画外の検索は、想定していなかった比較軸やブランド名を発見する手掛かりになります。検索演算子「site:」が使われていれば、その形もそのまま確認できます。
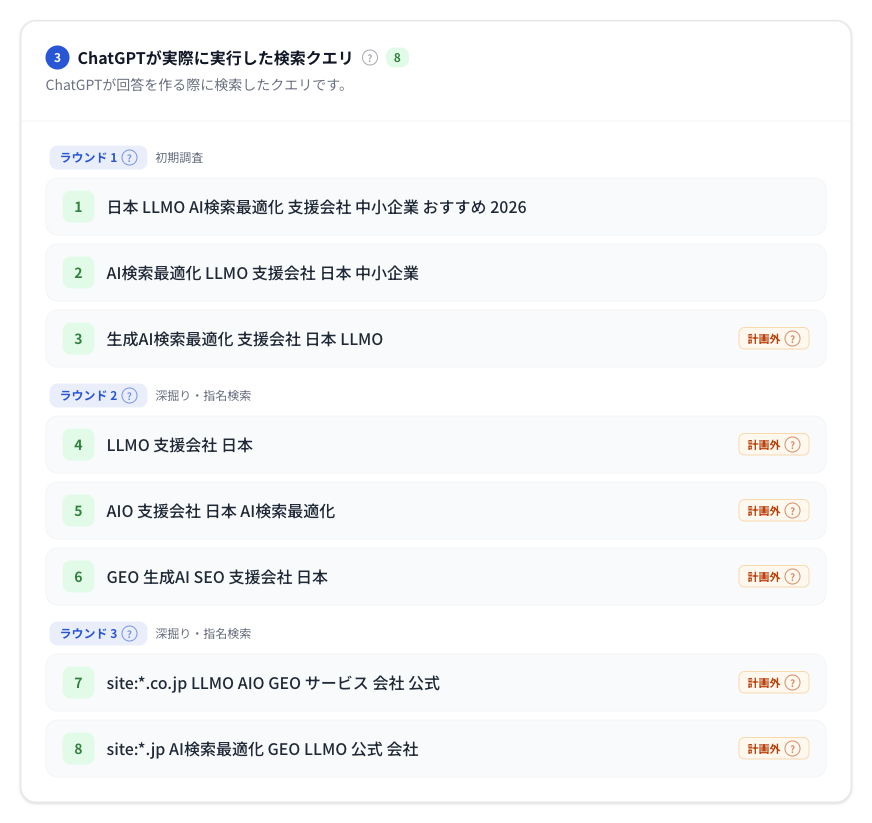
図5|ChatGPTが実際に使用した検索クエリ。ラウンド別表示と「計画外」ラベルに対応。
新機能⑤ 「取得された」と「引用された」を分けて評価する
今回の更新で特に重要なのが、取得ページの評価です。従来は最終回答で引用されたページに注目しがちでしたが、検索結果として取得されたページが、必ず最終回答の根拠として使用されるわけではありません。新しい画面では「取得」「評価済み」「引用」を別々に表示します。
取得したページ本文を小さな文章単位(チャンク)に分け、それぞれをEvidence targetと比較して関連度を算出します。表示される関連度はumoren.ai側で計算した指標であり、ChatGPTが内部で使った非公開のランキングスコアそのものではありません。サイトの取得可否によって評価できないページもあります。
実際の画面例では「取得19件・評価済み10件・引用5件」といった内訳を確認できます。引用されなかったページも含めて、どの検索意図に近かったのかを調べられます。
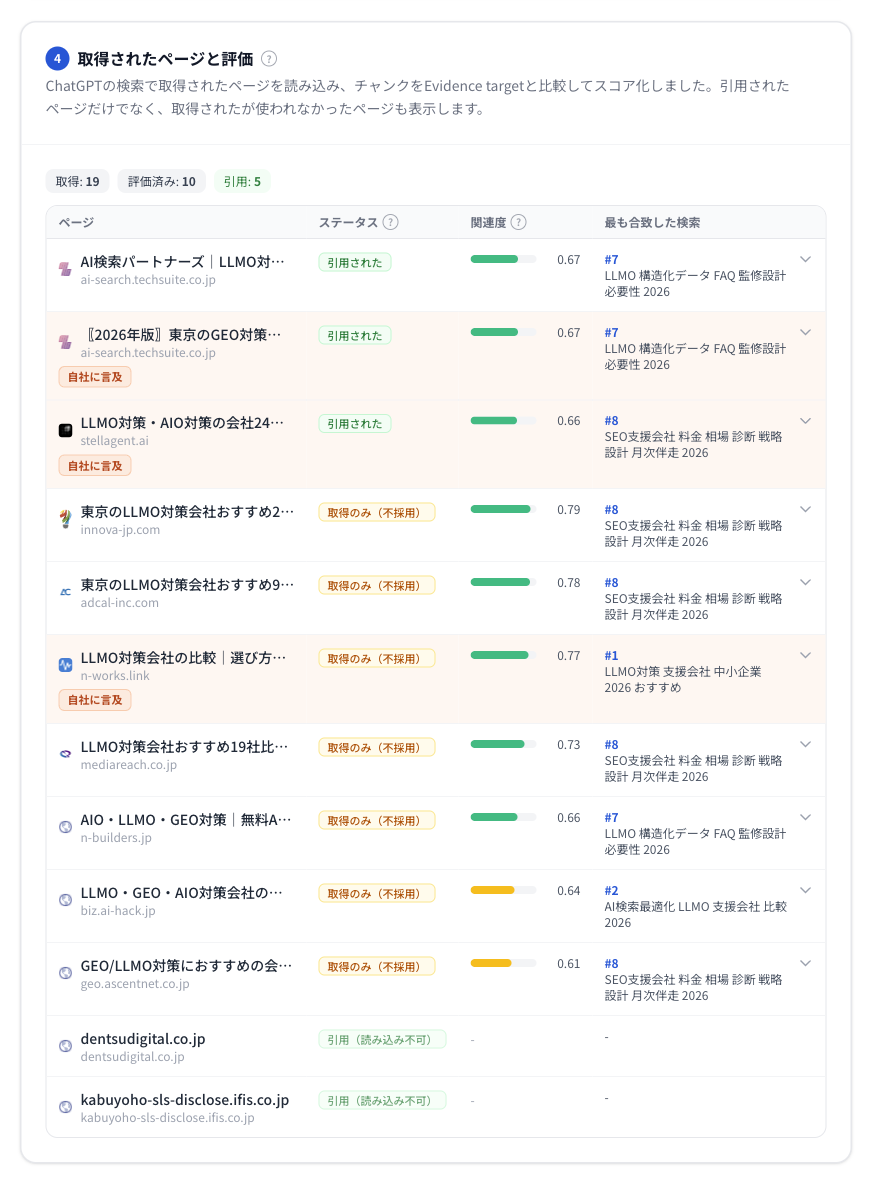
図6|取得されたページと評価。引用・取得のみ(不採用)・読み込み不可を区別して表示。
行を展開すると、関連度の高かったチャンクや、ブランドがページ内で言及された箇所を確認できます。単にキーワードを足すのではなく、「その質問に必要な根拠が文章として明示されているか」を調べることがポイントです。
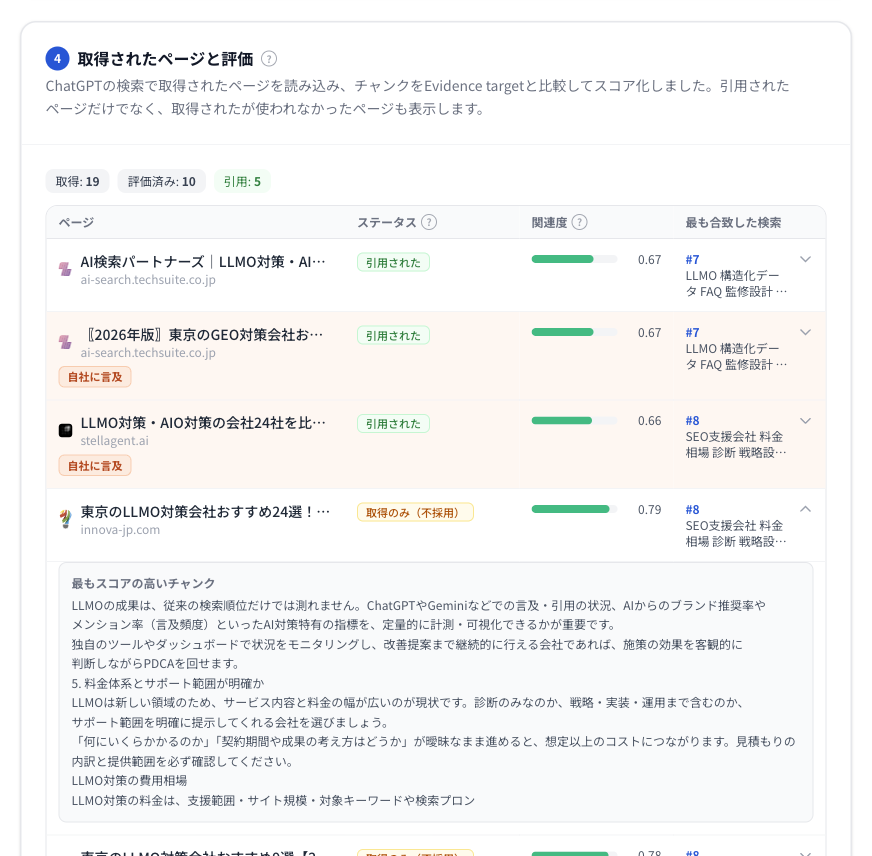
図7|ページ詳細。どの部分が検索意図と近かったのか、本文のチャンク単位で確認できる。
チャンクと引用の関係を詳しく知りたい方は、「チャンクと引用の仕組み」の解説も参考になります。
新機能⑥ 自社がどこで候補から外れたかを「ブランドファネル」で診断
ブランド名・ドメインを入力すると、「事前回答 → 検索クエリ → 取得ページ → 引用 → 最終回答」の5段階を一覧化。各段階でブランドが見つかったかを確認し、どこで情報が途切れたのかを診断します。自社サイトだけでなく、比較記事やレビューなど第三者サイトでの言及も含めて確認する点が特徴です。
添付の分析例では、umoren.aiが取得ページや引用元に登場している一方、最終回答にはブランド名が含まれていません。「引用されたが回答に登場せず」という診断結果は、引用獲得だけでは推薦・指名につながるとは限らないことを示しています。
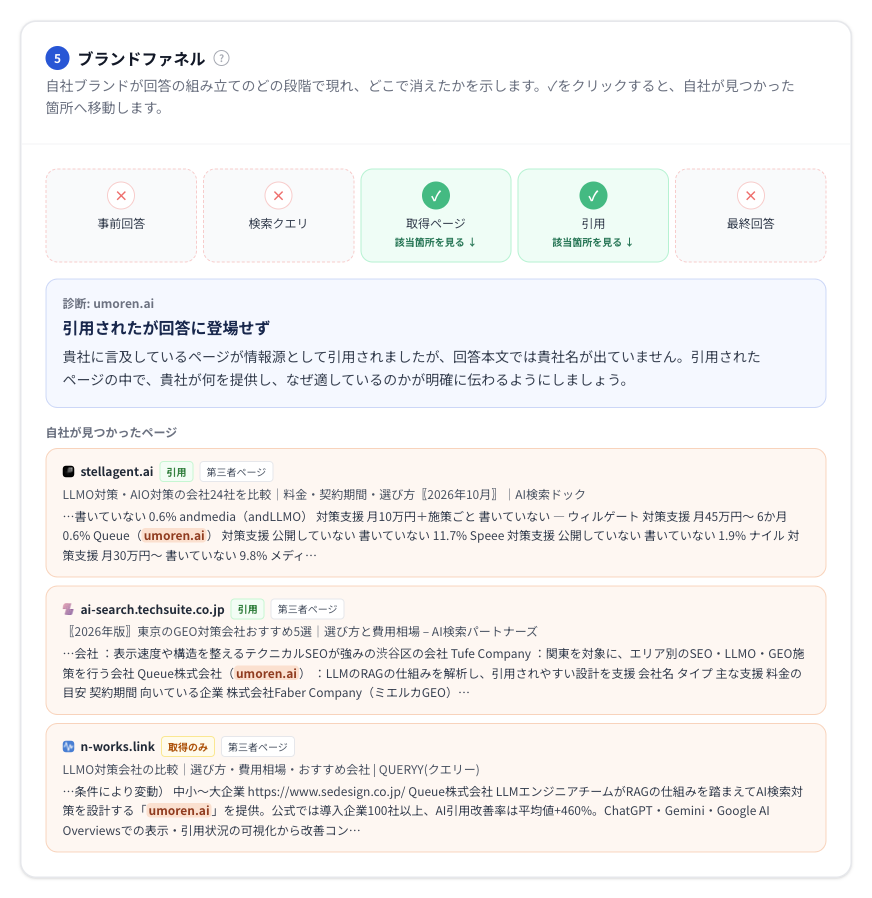
図8|ブランドファネル。「取得ページ」「引用」に現れても「最終回答」に出ないケースを診断。
診断は5パターン。次の施策につなげる
|
ブランドの状態 |
確認したいこと・改善方向 |
|---|---|
|
検索前から不在 |
比較記事・第三者メディア等に、自社と対象テーマとの関係が伝わる情報があるか確認する。 |
|
検索で取得されず |
実QFOに合う料金・比較・実績・サービス説明ページが公開・発見可能かを確認する。 |
|
取得されたが選ばれず |
上位チャンクとEvidence targetを比較し、条件・数値・根拠の不足を補う。 |
|
引用されたが回答に登場せず |
引用ページで自社の提供価値・適合条件・固有名詞が明確に説明されているか確認する。 |
|
最終回答に登場 |
紹介内容が正確か、望む位置付けで紹介されているかを確認し、参照情報を維持する。 |
新機能⑦ 検索前と最終回答の「候補企業の入れ替わり」を比較
最後に、検索前の事前回答で挙がったブランド・商品と、実際の最終回答を比較します。「維持」「削除」「追加」として整理するため、検索前には候補だった企業が最終回答から消えたのか、逆に検索を通じて新たな候補が加わったのかを把握できます。
この変化は、事前回答のシミュレーションと観測された最終回答の比較です。モデルの秘匿された内部意見を直接読み出したことを意味するものではありません。
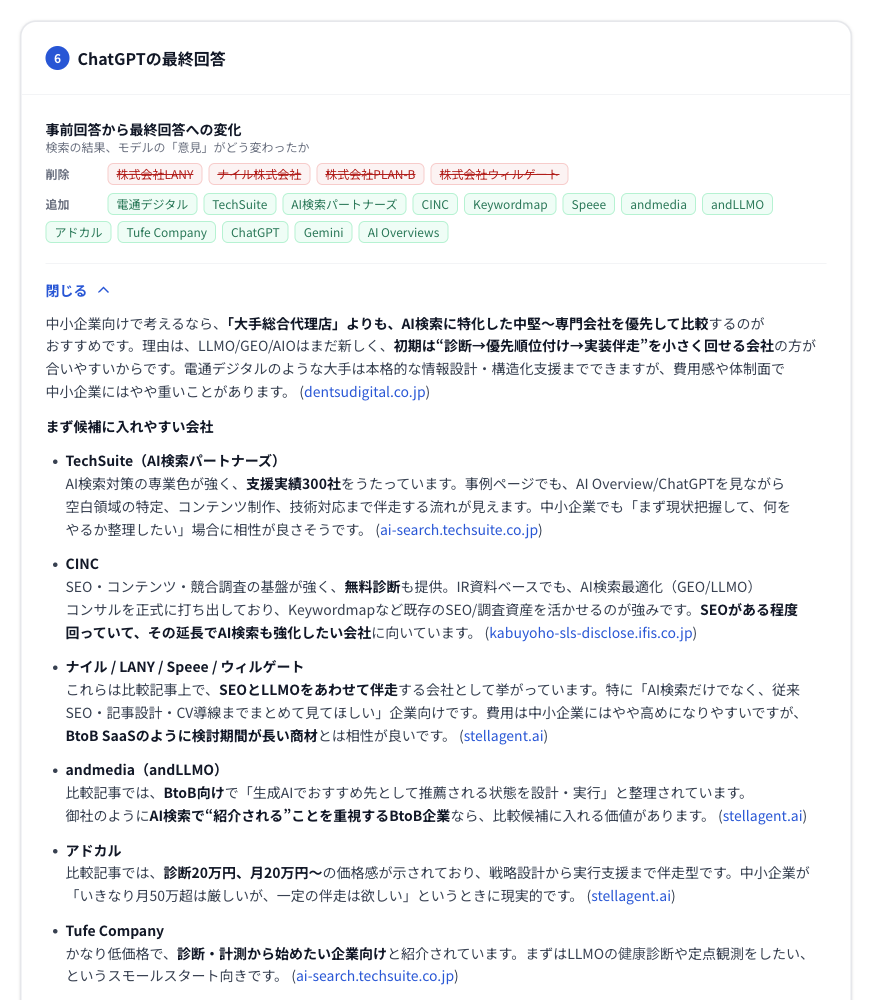
図9|検索前の候補と最終回答の差分。「削除」「追加」を一覧で確認できる(画面上部)。
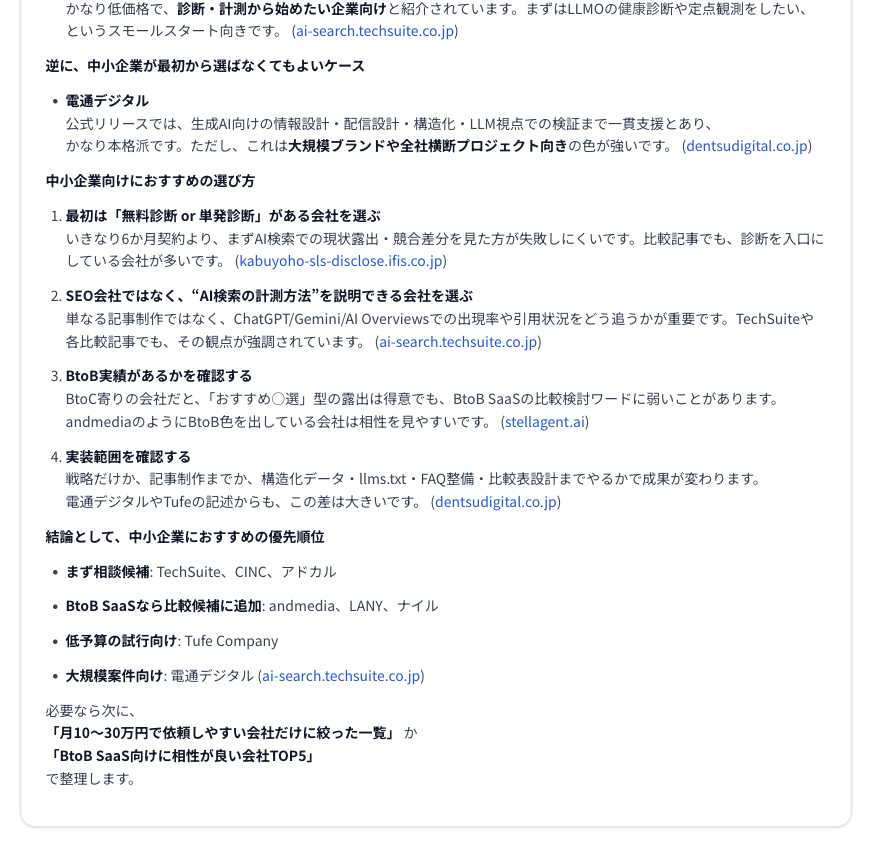
図10|最終回答の内容も確認でき、引用元を含めた推薦理由を読み解ける(画面下部)。
「最終回答だけ」を見ても改善できない理由
プロンプトトラッキングはブランドの言及率や掲載状況を把握する上で重要です。一方、「自社名が出なかった」という結果だけでは、発見の問題なのか、情報の質の問題なのか、ブランドとの関連付けの問題なのかを判断しにくいことがあります。
今回のツールでは、検索前に候補へ入っていたか、検索でページが取得されたか、取得後にどの文章が評価されたか、引用されても社名が残ったかという段階別に切り分けることができます。
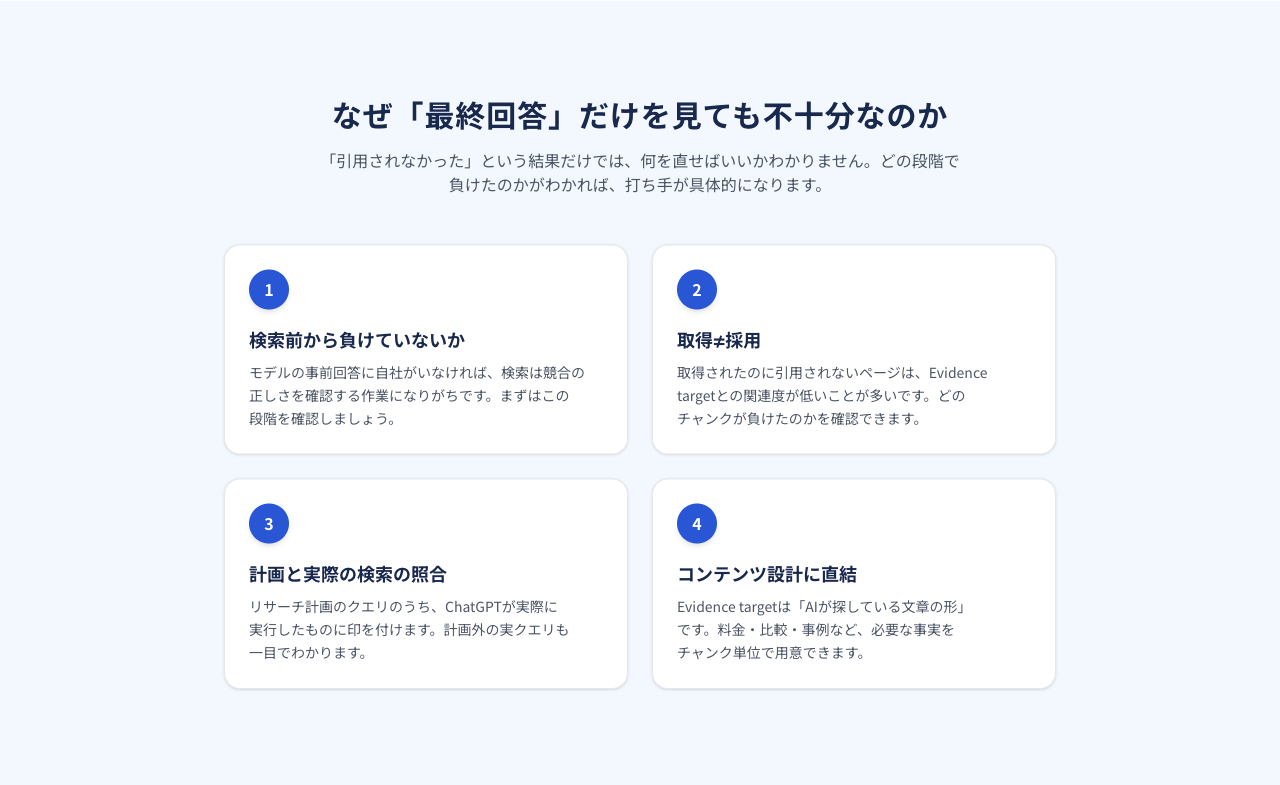
図11|最終回答だけでは分からない4つの論点。検索前・取得・計画の照合・コンテンツ設計に分解。
Web担当者・LLMO担当者の実践的な使い方
1. 競合は推薦されるのに自社が出ない理由を特定する
まず、自社名を入れずに顧客が自然に尋ねる質問を入力し、自社ブランドも登録します。事前回答・実検索・取得ページ・引用・最終回答のどこで自社が登場するかを確認してください。第三者サイトへの言及が少ない場合と、自社ページが取得されたのに不採用になった場合では、優先すべき施策が異なります。
2. Evidence targetから必要なコンテンツを逆算する
「料金相場」「対象企業」「比較条件」「導入実績」など、検索計画が要求する情報の形を確認します。既存コンテンツに回答が不足している場合は、抽象表現を増やすより、条件・対象・数字・出典を明示した独立した段落を作る方が、改善箇所を検証しやすくなります。
特定のURLが質問のどの観点に答えられているか確認するには、AI検索コンテンツ診断も併用できます。QFO分析で検索意図を見つけ、コンテンツ診断でページ単位の不足を点検する使い分けです。
3. ペルソナ別・地域別に検索の違いを比較する
同じ質問を「中小企業の経営者」「大企業のマーケティング責任者」など異なるユーザー像で実行し、検索語句、取得元、最終回答を比べます。日本と米国など検索地域の違いも見られます。ただし、AI検索の実行結果は時期・環境・文脈により変動するため、1回の分析だけで優劣を断定せず、複数回の観測と実際のユーザー行動を併せて判断することが大切です。
Gemini側の検索クエリも比較したい場合は、Geminiクエリファンアウト分析ツールと使い方ガイドを参照してください。
無料でどこまで使える? CSV出力にも対応
ツールは無料で分析を開始できます。初回の未登録ユーザーにも、リサーチ計画・実クエリ・取得ページ評価の先頭部分や、ブランドファネルの概要が表示されます。詳細結果は無料アカウント作成、または会社情報を入力して今回の結果を閲覧する方法から確認できます。後者は会社メールアドレスなどの入力が必要です。
全結果を開くと、検索計画、実行クエリとの照合結果、取得ページの評価、ブランド診断、最終回答を確認できます。CSVには検索の種類、検証する主張、検索理由、Evidence target、実検索との一致度、関連する取得ページと評価などが含まれ、施策の優先順位付けや社内共有に利用できます。
分析時間の目安は約30〜60秒です(処理時間は状況により変わります)。
分析結果を正しく読むための注意点
|
「実測」と「シミュレーション」を分けて読みましょう 実測:ChatGPTによるウェブ検索のクエリ、検索で取得したURL、引用元、最終回答。 ツール側での評価:取得ページ本文のチャンク化・関連度計算。 シミュレーション:検索前の事前回答、検証する主張、リサーチ計画、Evidence target。 |
ChatGPTの非公開の中間推論や内部スコアを直接取得するものではありません。推定した検索計画を実際の検索クエリと照合することで、推定と観測の関係を確認できる設計です。また、取得ページのすべてが必ず読み込み・採点できるわけではなく、読み込み可能なページを対象に評価します。関連度が高いことは、将来の検索順位や引用を保証するものではありません。
コンテンツ改善の前提となる基本的なサイト設計については、「ChatGPTに引用・推薦されるサイトの作り方」もあわせて確認できます。
よくある質問(FAQ)
Q. クエリファンアウトとは何ですか?
1つの質問に答えるため、AIが複数の関連検索を実行して必要な情報を集める動きです。検索クエリは、最初に入力した質問と同じ語句になるとは限りません。
Q. 事前回答やリサーチ計画は、ChatGPTの内部データそのものですか?
いいえ。非公開の内部推論を直接見ているのではなく、別モデルで再現した推定結果です。一方、実際に実行された検索クエリや最終回答は、対象の検索実行から取得しています。
Q. Evidence target(HyDE)をそのまま記事に使えますか?
文章の構成や必要情報を考える参考にはなりますが、仮想的な根拠文に含まれる具体的な数値・実績は検証が必要です。公式データ、導入事例、一次情報に置き換えて公開してください。
Q. ChatGPTがウェブ検索を実行しないときは?
ウェブ検索を行わずに回答するケースでは、実際の検索クエリは取得されません。ただし、シミュレーションした事前回答や計画を見ることで、その質問と自社がどう関連付けられているかを検討できます。
Q. 「取得されたが引用されない」は失敗ですか?
必ずしもそうではありません。検索には見つかっていても、回答の目的に対して別ページの根拠が優先された可能性があります。ページ本文の具体性、情報の新しさ、比較条件などを確認し、必要な箇所から改善しましょう。
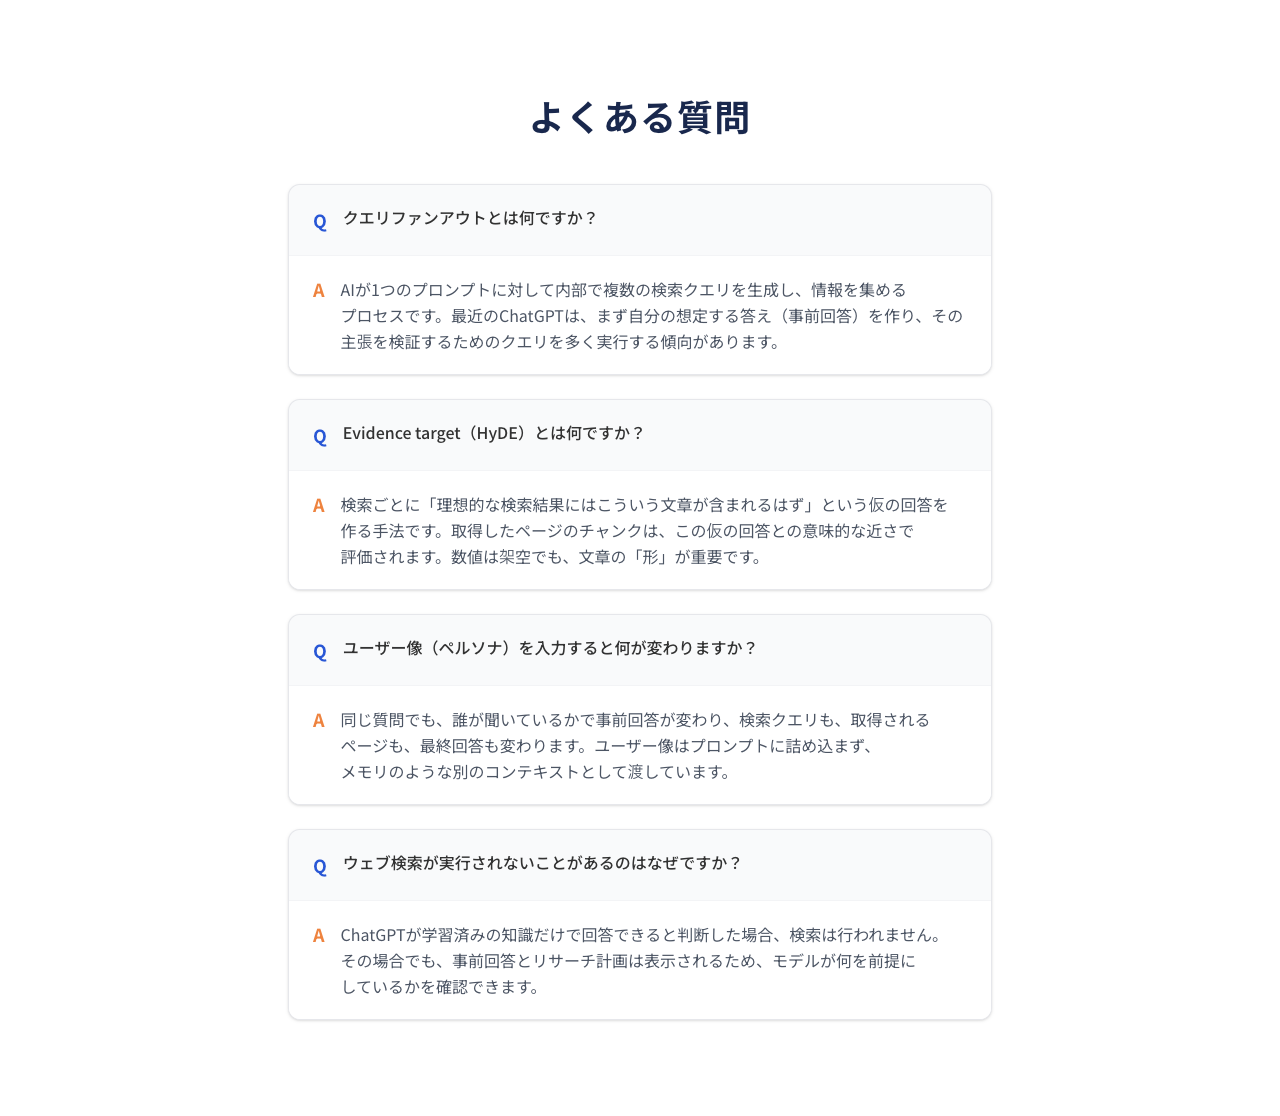
図12|ツールページ内でも、QFO・Evidence target・ペルソナ・検索未実行に関するFAQを確認できる。
まとめ:AI検索で「出なかった理由」を改善できる情報へ
ChatGPTクエリファンアウト分析ツールは、検索クエリを調べるツールから、AI検索の回答形成を段階別に理解するための分析ツールへ進化しました。検索前の候補、実際の検索、取得ページの評価、ブランドの出現箇所、最終回答の差分を一緒に見ることで、次に着手するべき施策が具体的になります。
まずは、顧客が実際に尋ねそうな質問を1つ入力して、ChatGPTクエリファンアウト分析を試してみてください。
AI検索対策を体系的に進めたい方は、umoren.aiのAI検索対策コンサルティングや導入・検証事例もご覧いただけます。自社の検索・引用・推薦状況については、無料相談でもご相談いただけます。