自社サイトはAIの学習データに含まれる? 無料「AI事前学習データチェッカー」でCommon Crawlの保存状況を確認する方法
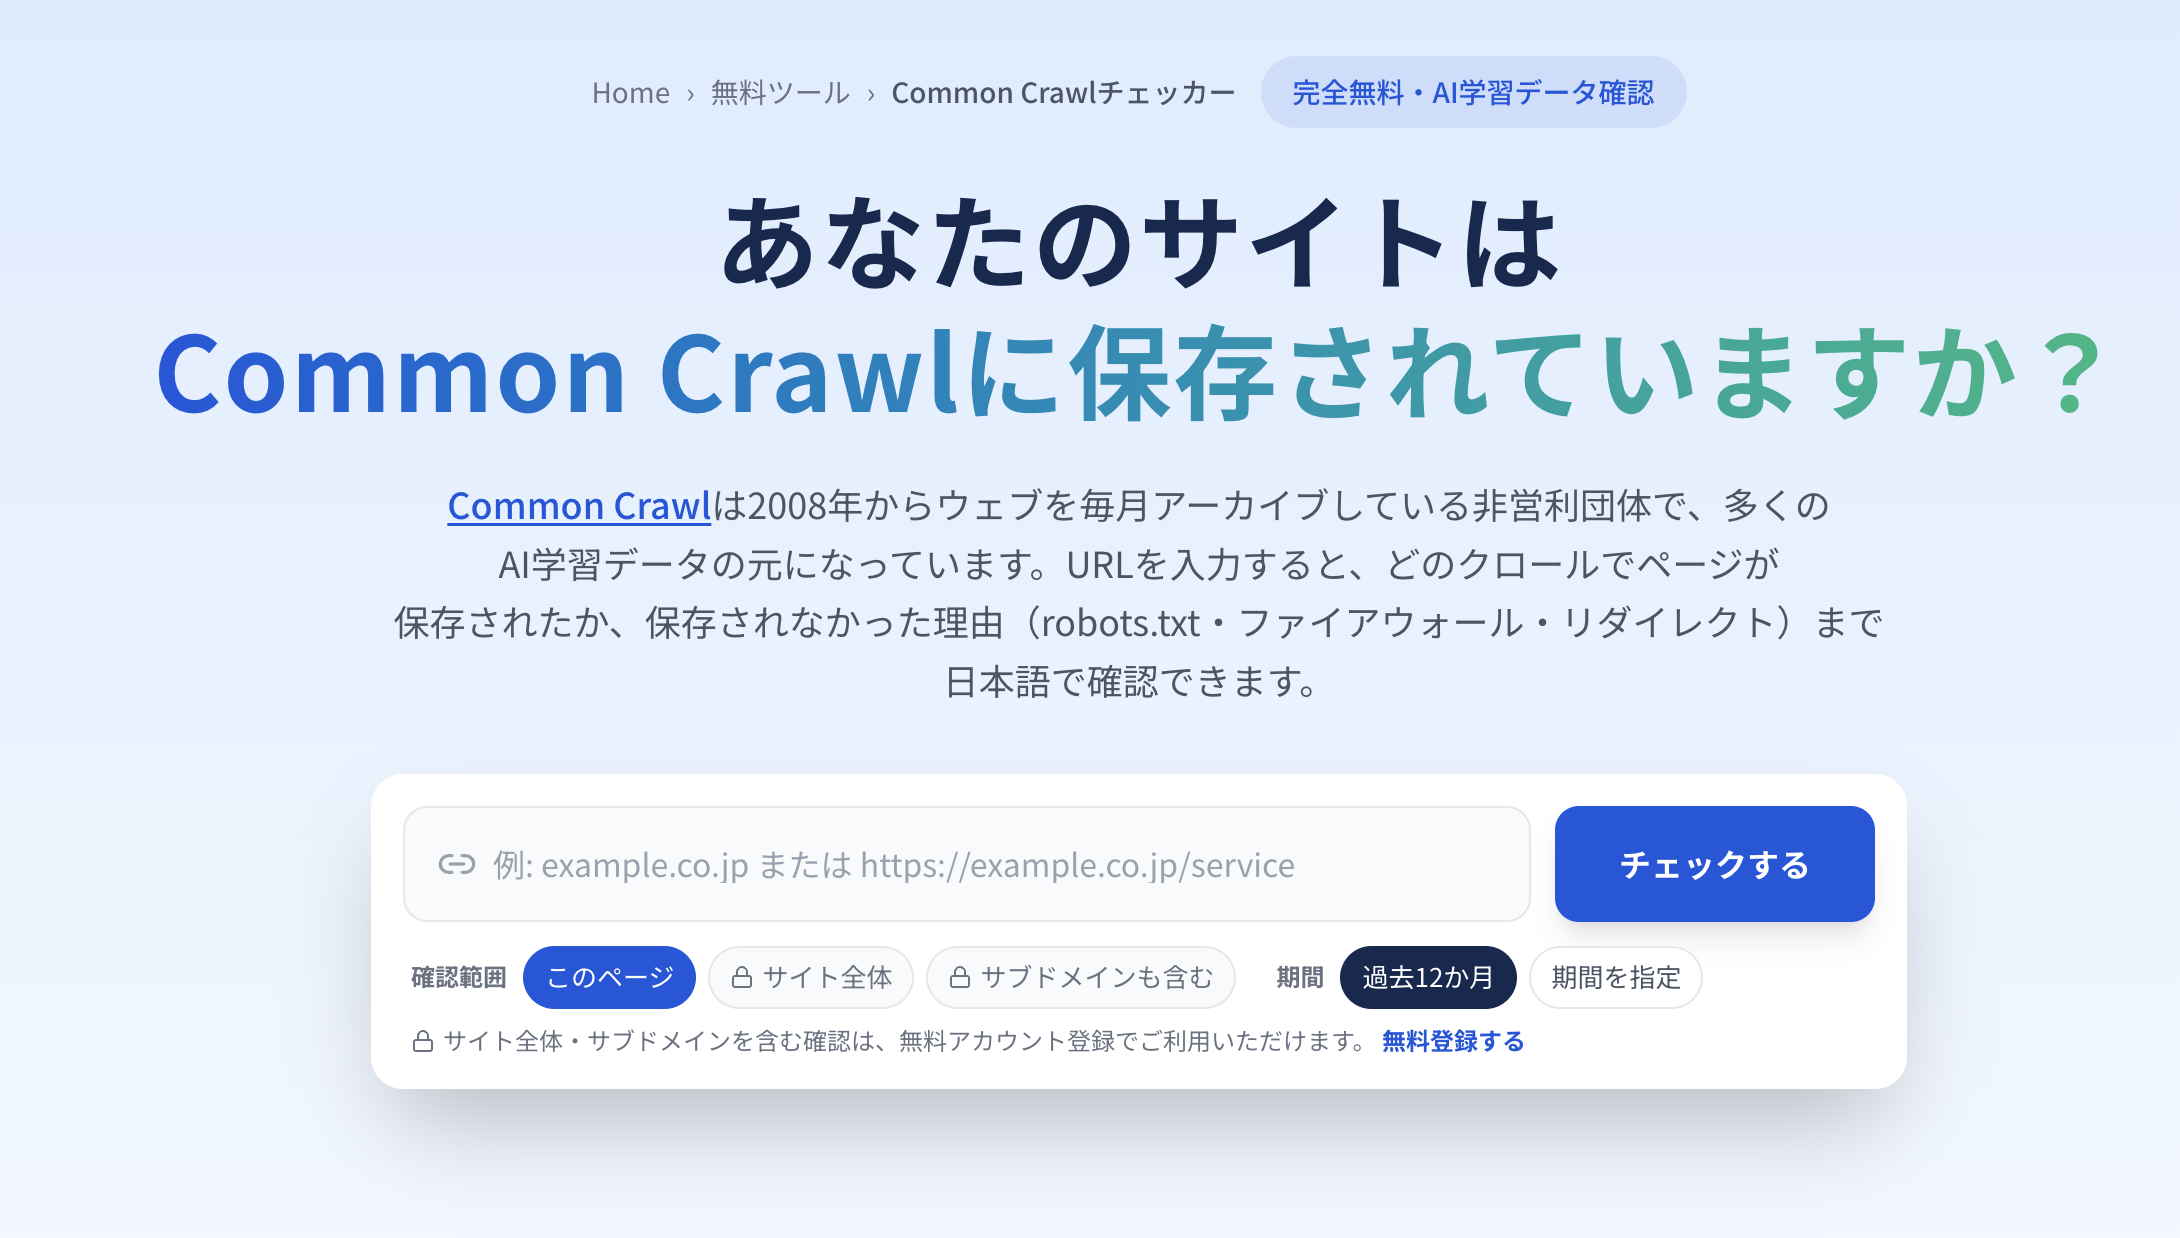
ChatGPTなどの生成AIに自社がなかなか登場しない。その原因をコンテンツの質やSEOだけに求めていませんか。そもそもAI学習データの素材となるウェブアーカイブに、自社サイトの情報が保存されているかを確認することも、重要な現状把握の一つです。
umoren.aiは、URLを入力するだけでCommon Crawlの保存記録を照会できる「AI事前学習データチェッカー(Common Crawl)」を無料公開しました。いつ、どのURLが保存されたかだけでなく、robots.txt、ファイアウォール、リダイレクト、保存HTMLの内容まで日本語で確認できます。
▶ 今すぐ無料で確認:AI事前学習データチェッカーを使う
|
この記事でわかること Common CrawlとAIの事前学習の関係/無料ツールの機能と使い方/200・301・403などの結果の解釈/CCBotを妨げる設定の見つけ方/LLMOで次に取り組む施策 |
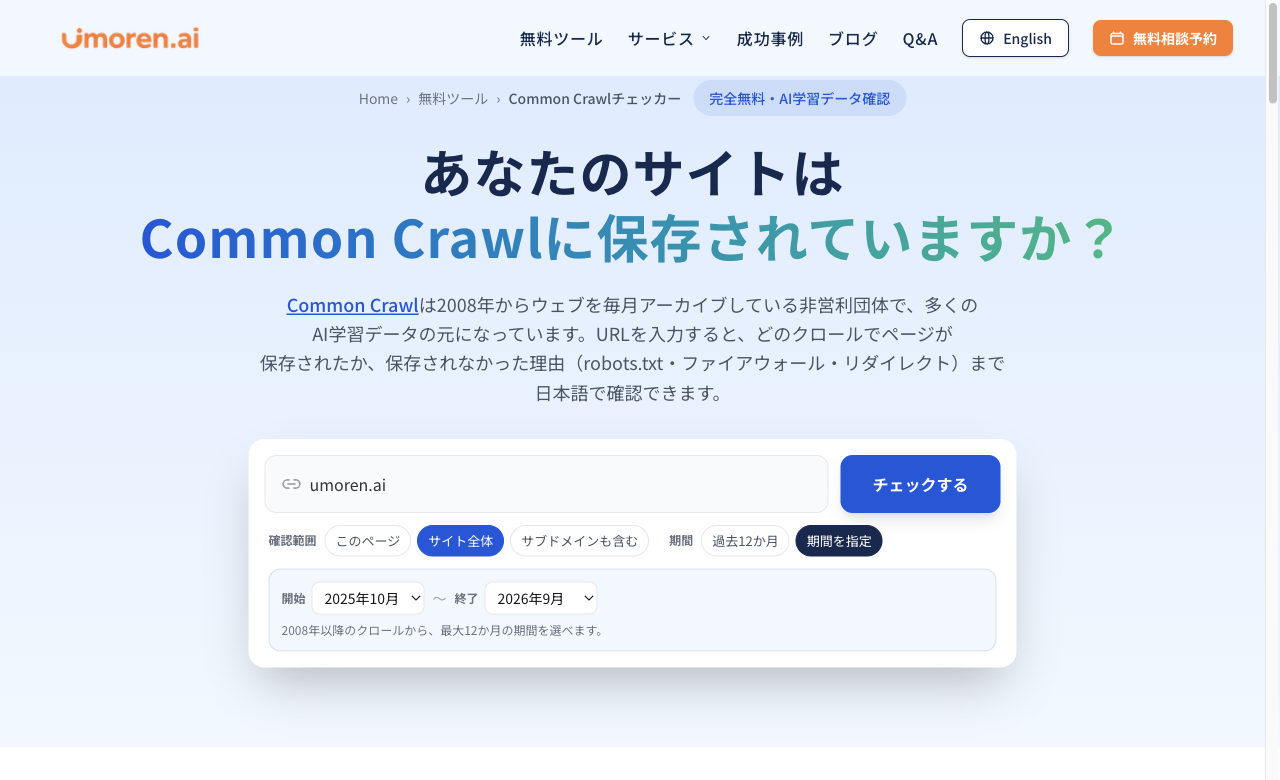
図1|URL・確認範囲・期間を指定する診断画面。初期設定は過去12か月(画像は旧名称表示時のUI)。
Common Crawlとは?なぜAI学習データの確認に関係するのか
Common Crawl(コモンクロール)は、2008年から公開ウェブを収集・保存し、そのデータを公開してきた米国の非営利団体です。クローラー「CCBot」が収集したウェブページは、研究者やAI開発企業が学習用データセットを構築する際の代表的な材料の一つになっています。近年はおおむね月1回、新しいクロールが公開されています。
ただし、Common Crawlは「学習済みサイトの名簿」ではありません。AI開発企業はアーカイブを重複排除・品質評価などで大幅に選別します。また、ChatGPT検索やPerplexityなどが回答時に参照するウェブ検索用クローラーと、事前学習用アーカイブの収集経路は別です。
|
重要 Common Crawlに保存されていても、特定のAIモデルがそのページを学習したと証明できるわけではありません。逆に、保存記録がなくてもリアルタイムAI検索から必ず除外されるわけではありません。 |
AIクローラーの基本や引用されるサイト設計を詳しく知りたい方は、ChatGPTに引用・推薦されるサイトを作る方法もご覧ください。
無料「AI事前学習データチェッカー」でできる6つのこと
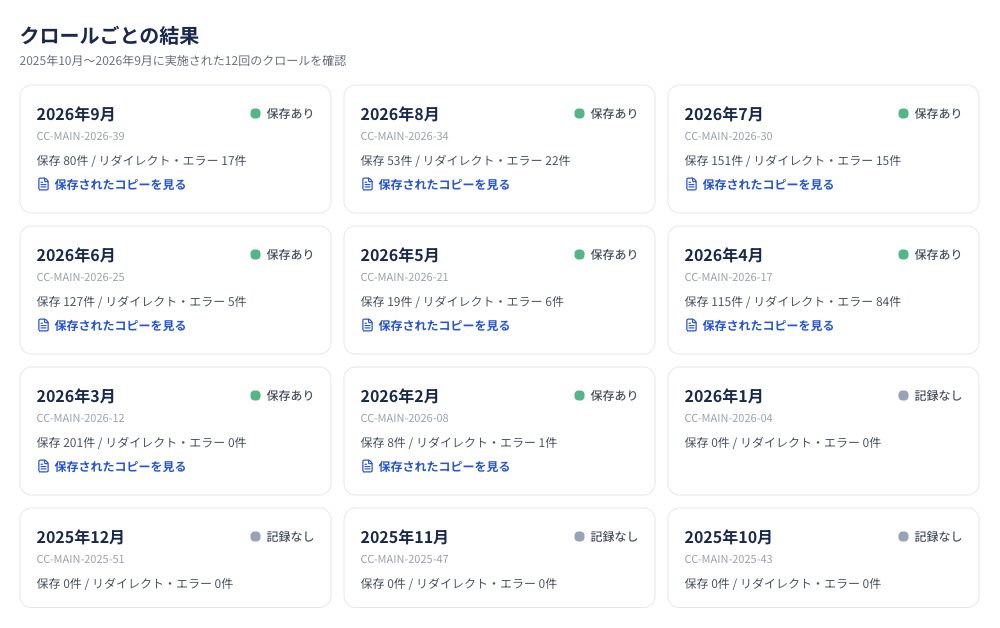
1.クロールごとの保存・リダイレクト・エラーを確認
Common Crawlの公式インデックスを新しい順に照会し、各クロールの保存件数やエラー・リダイレクトの記録を月単位で表示します。「先月は保存されたのに、今月はエラーが増えた」といった変化を把握するのに役立ちます。
図2|月別のクロール結果。保存件数とリダイレクト・エラーを比較できる。
2.2008年からのクロール履歴をタイムラインで可視化
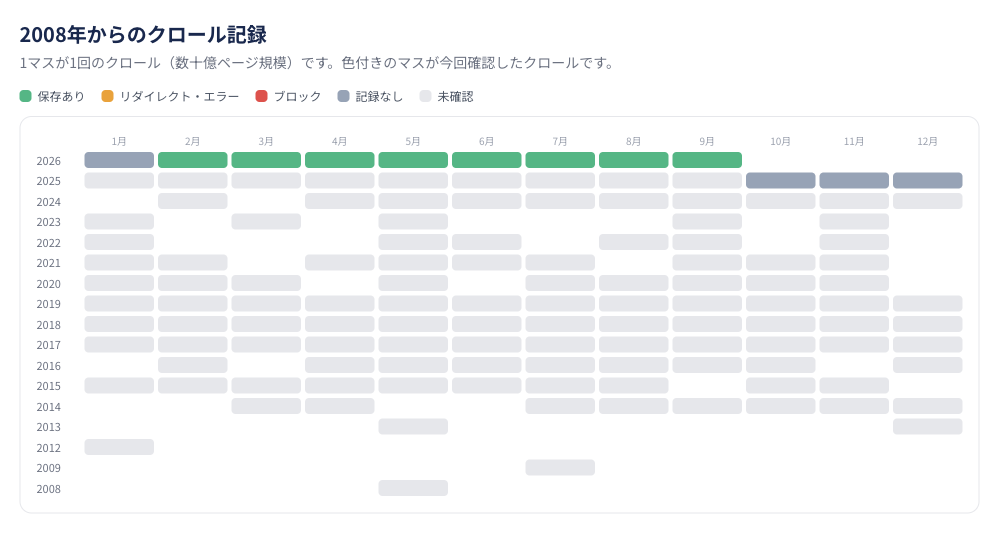
クロールの有無と確認結果を、年×月のヒートマップで可視化します。確認したクロールは色分けされるため、サイト公開後の変化やリニューアル前後の傾向を見渡せます。初期の2008〜2012年頃は月次クロールが少ないため、月別比較には注意が必要です。
図3|2008年以降のクロール記録を一覧化。色は保存・エラー・ブロックなどを表す。
3.当時のrobots.txtから、CCBotとAIボットへの指示を確認
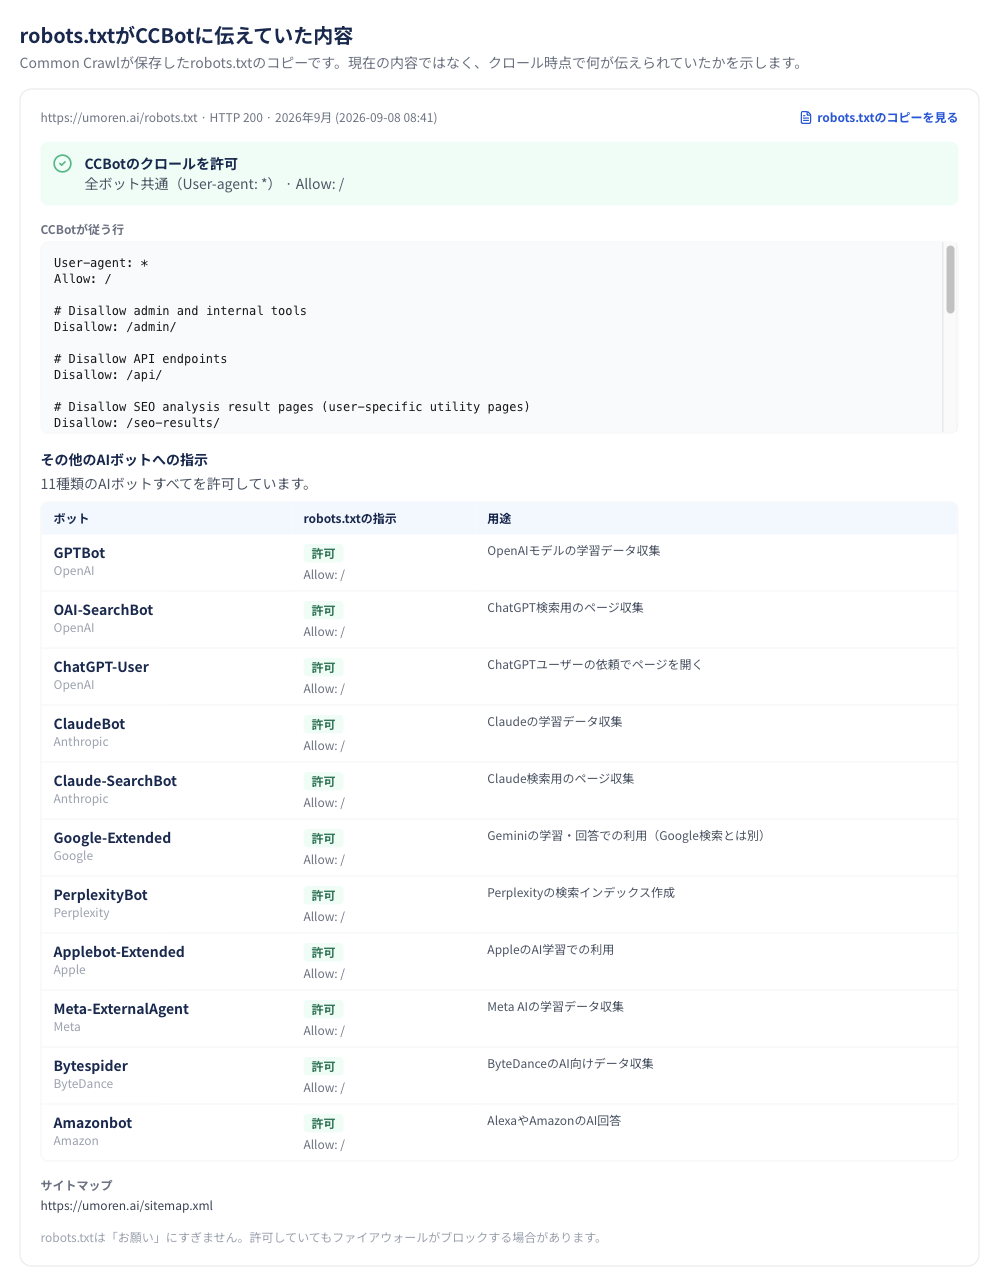
現在のrobots.txtを読むだけでは、「過去のクロール時点で何が指定されていたか」はわかりません。本ツールはCommon Crawlが保存した当時のrobots.txtを参照し、CCBotに適用されたルールと、主要AIボットへの許可・拒否の状態をまとめて表示します。
対象にはCCBotのほか、GPTBot、OAI-SearchBot、ChatGPT-User、ClaudeBot、Claude-SearchBot、Google-Extended、PerplexityBotなどが含まれます。ただし、それぞれ役割が異なり、すべてを許可すべきという意味ではありません。学習利用を許可するか、検索で参照されることを許可するかは自社ポリシーに合わせて判断してください。
図4|CCBotがクロール時に見たrobots.txtと、主要AIボット向けルールの確認画面。
4.Cloudflareなどによるブロックの可能性と対処先を確認
robots.txtで許可していても、CDN・WAF・セキュリティプラグインがクローラーへのアクセスを拒否する場合があります。403・429・503などが記録されていれば、保存されたレスポンスヘッダーやブロック画面から、Cloudflare、Sucuri、Akamai、AWS WAF、Wordfenceなどのサービスを推定し、確認すべき設定を案内します。識別できない場合は無理に特定しません。
5.CCBotが保存した「実際のHTML」を4つのタブで確認
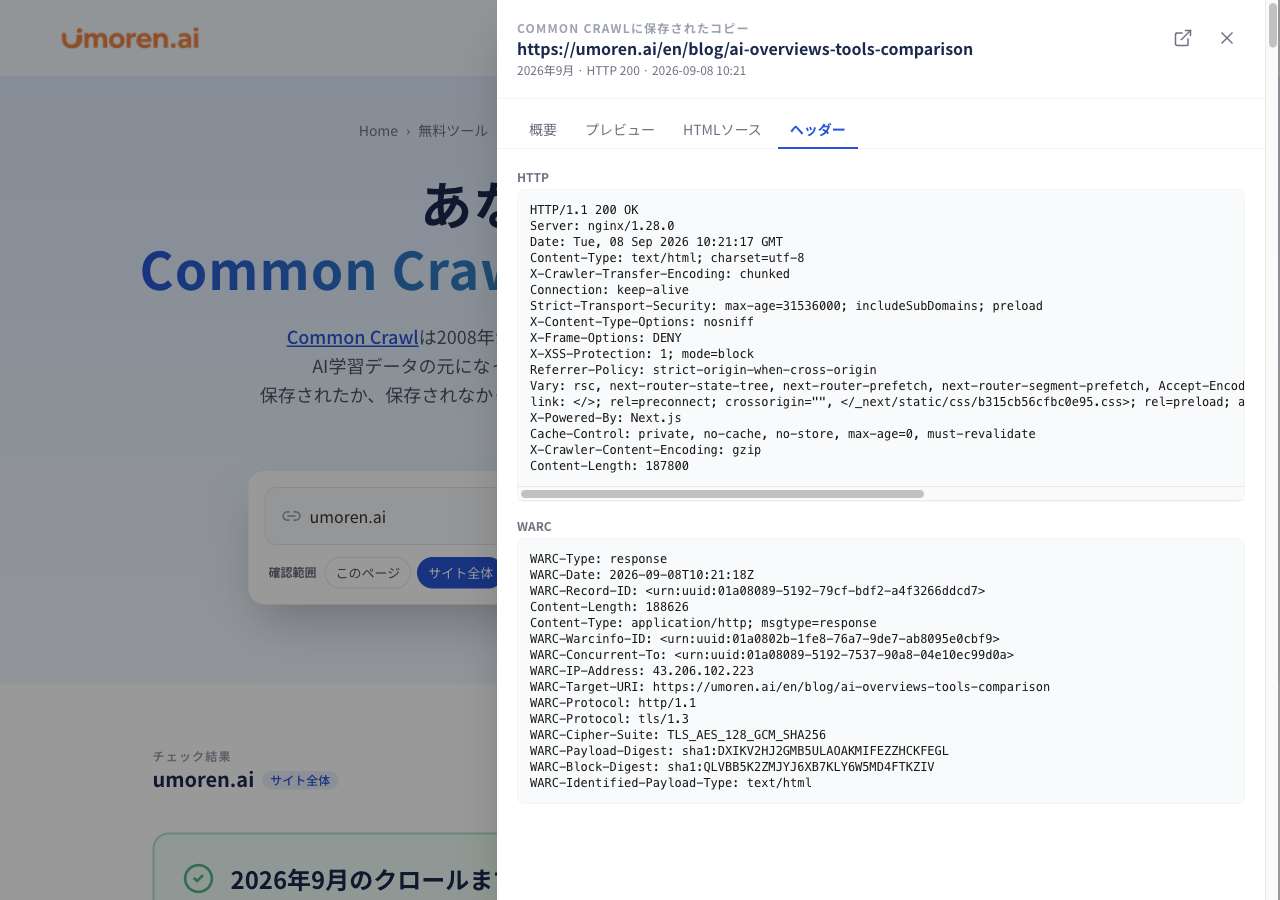
保存されたページは、タイトル・メタディスクリプション・H1・canonical・言語・テキスト量などの「概要」、JavaScript無効の「プレビュー」、「HTMLソース」、「HTTP/WARCヘッダー」の4タブで確認できます。見た目が整ったページでも、初期HTMLに本文がなければ、CCBotには十分な情報が残らないことがあります。
図5|保存コピーの「概要」。title、description、H1、canonical、テキスト量などを確認。
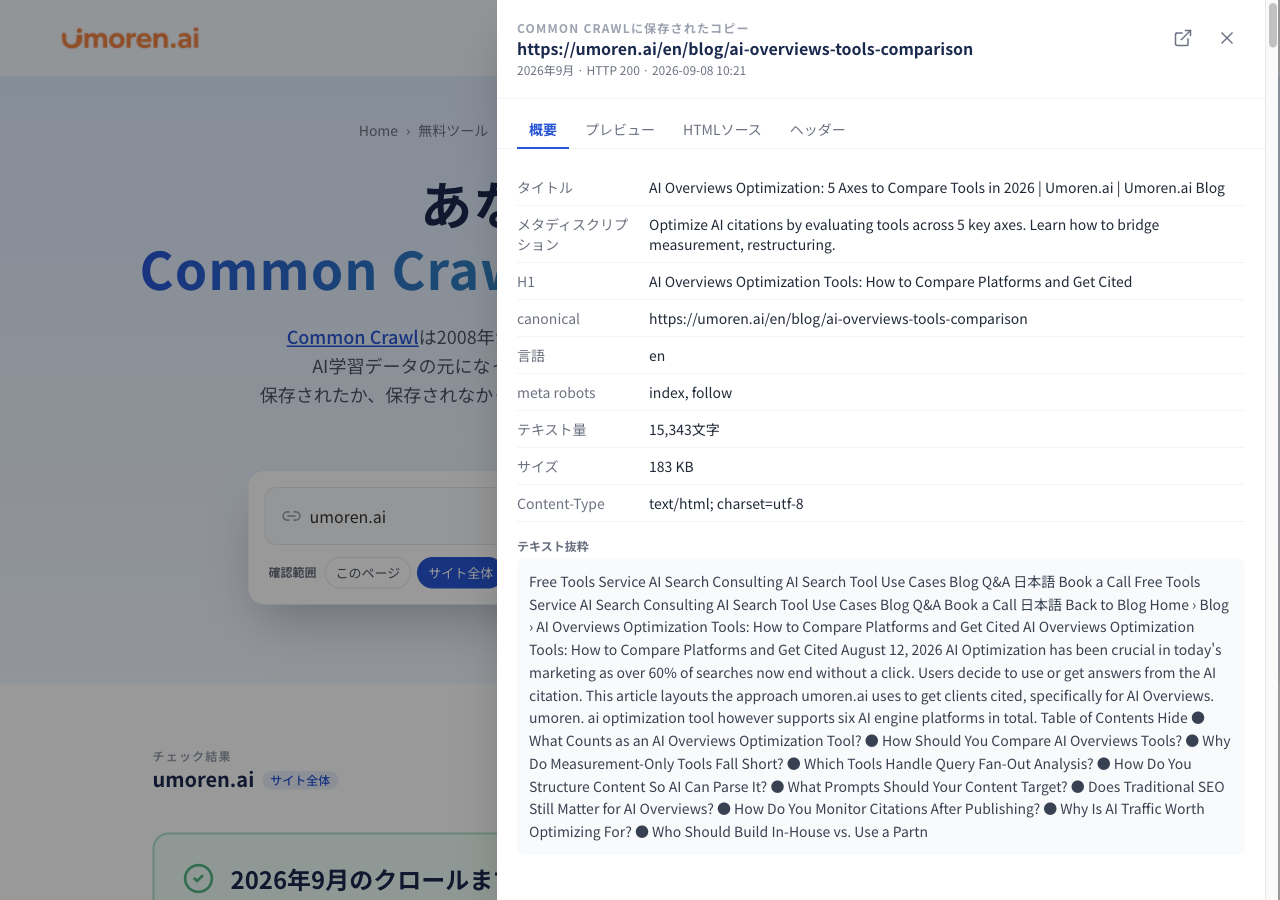
図6|「プレビュー」。JavaScriptを無効化した状態で、保存されたページの見え方を確認。
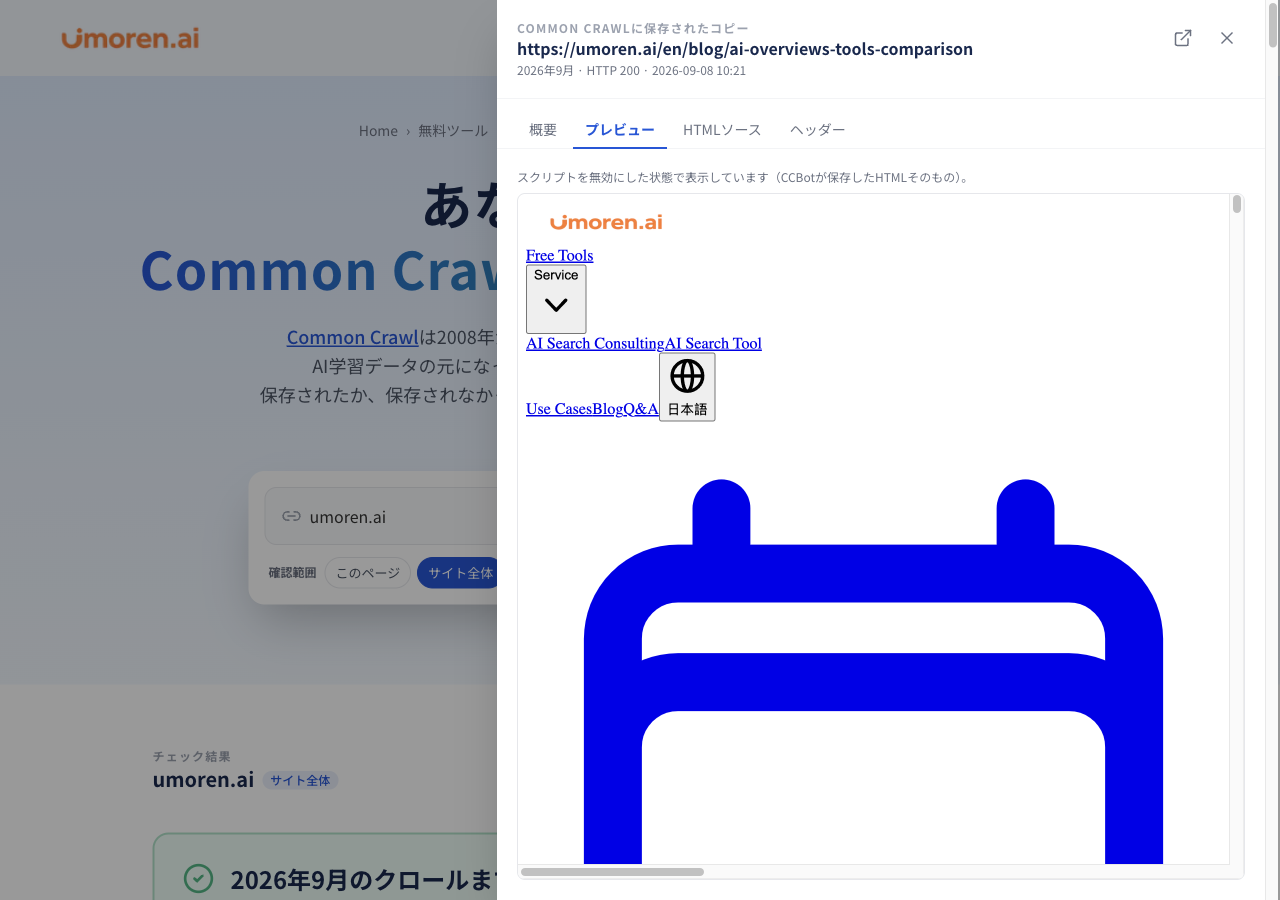
図7|「HTMLソース」。CCBotが受け取ったHTML本文を点検できる。
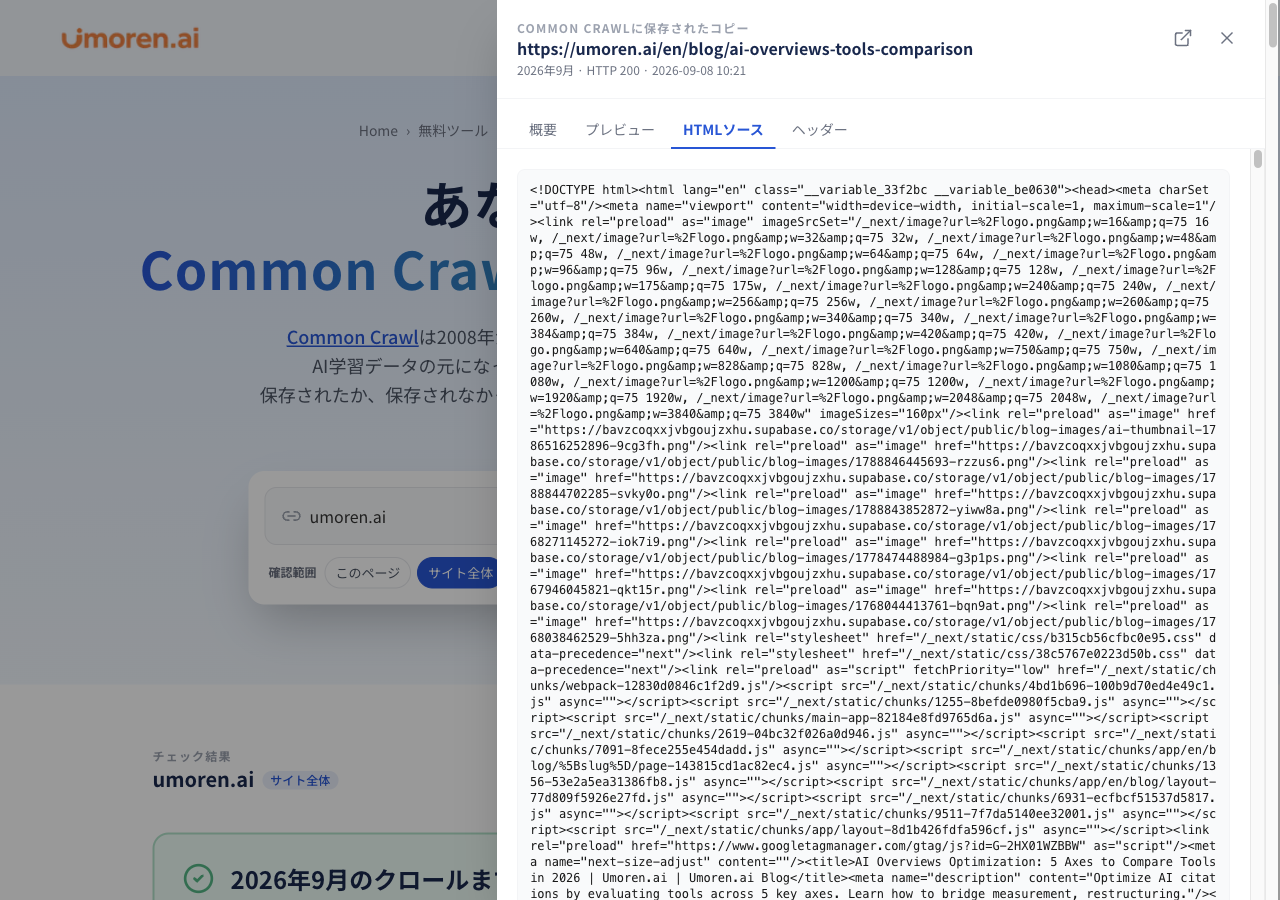
図8|「ヘッダー」。HTTPレスポンスとWARC記録を確認できる。
6.取得記録をURL単位で絞り込み、CSVでダウンロード
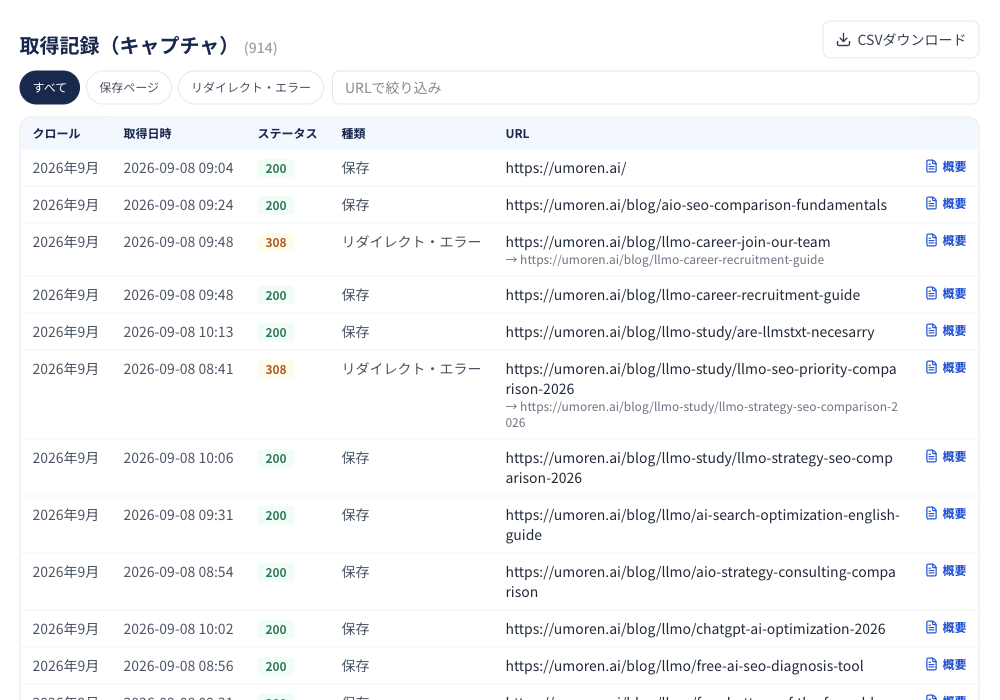
クロール月・取得日時・HTTPステータス・取得種別・URLを一覧表示します。保存ページのみ、リダイレクト・エラーのみ、URL文字列での絞り込みに対応し、CSVのダウンロードや結果共有も可能です。どのディレクトリが保存されているか、URL変更後に旧URLが残っていないかの調査にも使えます。
図9|取得記録(キャプチャ)一覧。URLフィルターとCSVダウンロードを備える。
使い方:URLを入力するだけの3ステップ
STEP 1|ページURLまたはドメインを入力する
AI事前学習データチェッカーを開き、調べたいページのURL、またはexample.co.jpのようなドメインを入力します。「このページ」は登録なしで確認でき、「サイト全体」「サブドメインも含む」は無料アカウント登録後に利用できます。
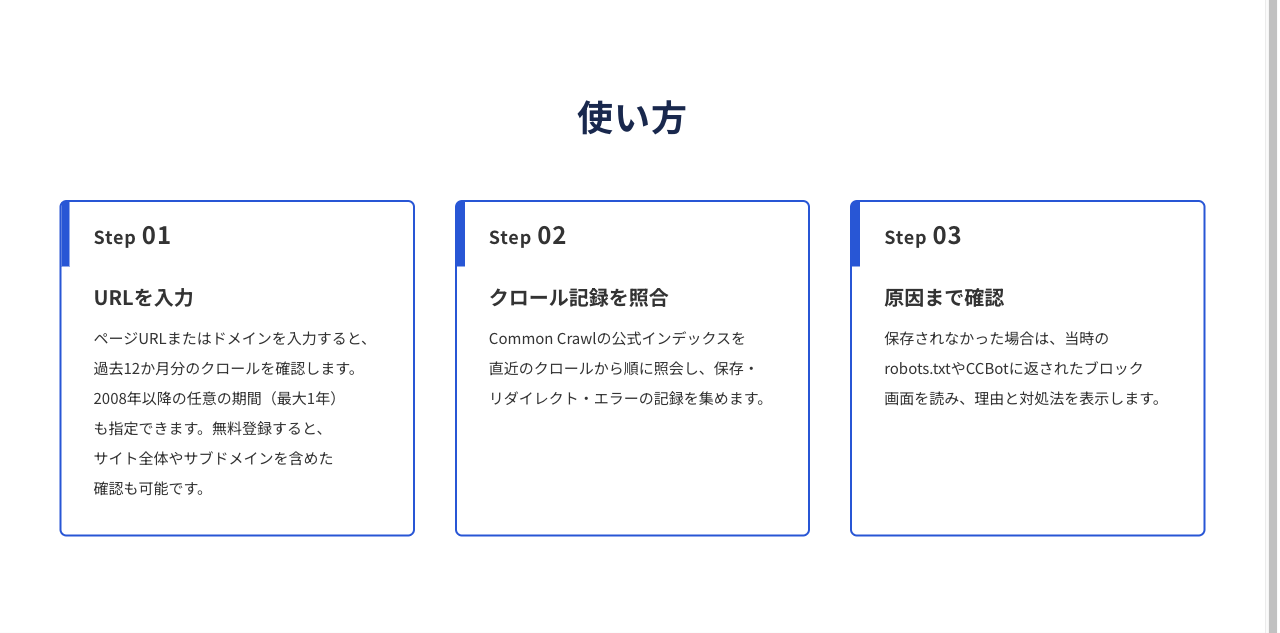
期間は「過去12か月」が標準です。「期間を指定」では2008年以降の公開済みクロールを対象に、最大12か月間を選択できます。1回の診断で照会するクロールは最大12回です。
図10|画面内の「使い方」案内。入力→記録照合→原因確認の3段階。
STEP 2|クロールの照合完了を待つ
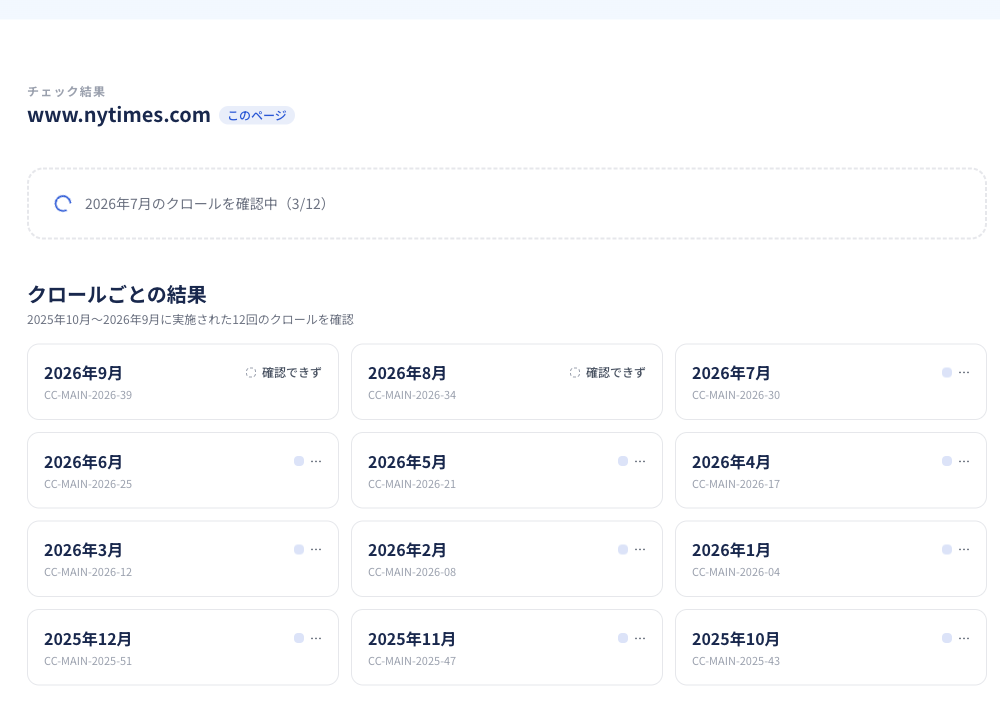
ツールはCommon Crawlの公開インデックスをクロールごとに照会します。混雑状況によっては1回のクロール照合に数秒〜数十秒かかることがあり、進捗を画面で確認できます。診断時に対象サイトへ直接アクセスするのではなく、Common Crawlが公開した記録を調べる方式です。
図11|確認中は「3/12」のように進捗を表示。
STEP 3|判定と月別の詳細を確認する
最初に「保存されています」「robots.txtでブロック」「サーバーが拒否」「リダイレクト」「記録なし」などの判定が表示されます。さらに月別の結果、過去のrobots.txt、実際の保存HTMLまで確認することで、必要な改善策を具体化できます。詳細機能の表示には無料登録、または結果の一時アンロックが必要になる場合があります。
図12|診断結果の例。umoren.aiでは、2026年9月までに500件のURL保存を確認。
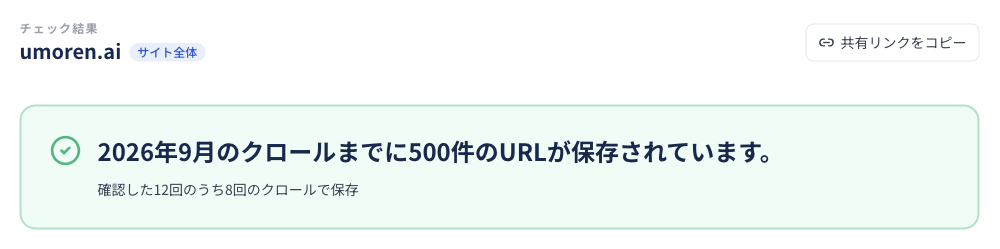
上のumoren.aiの例では、確認した12回のうち8回のクロールで保存記録が見つかっています。これは指定期間・指定範囲の診断例であり、AIモデルへの学習やChatGPTでの推薦を証明する数値ではありません。
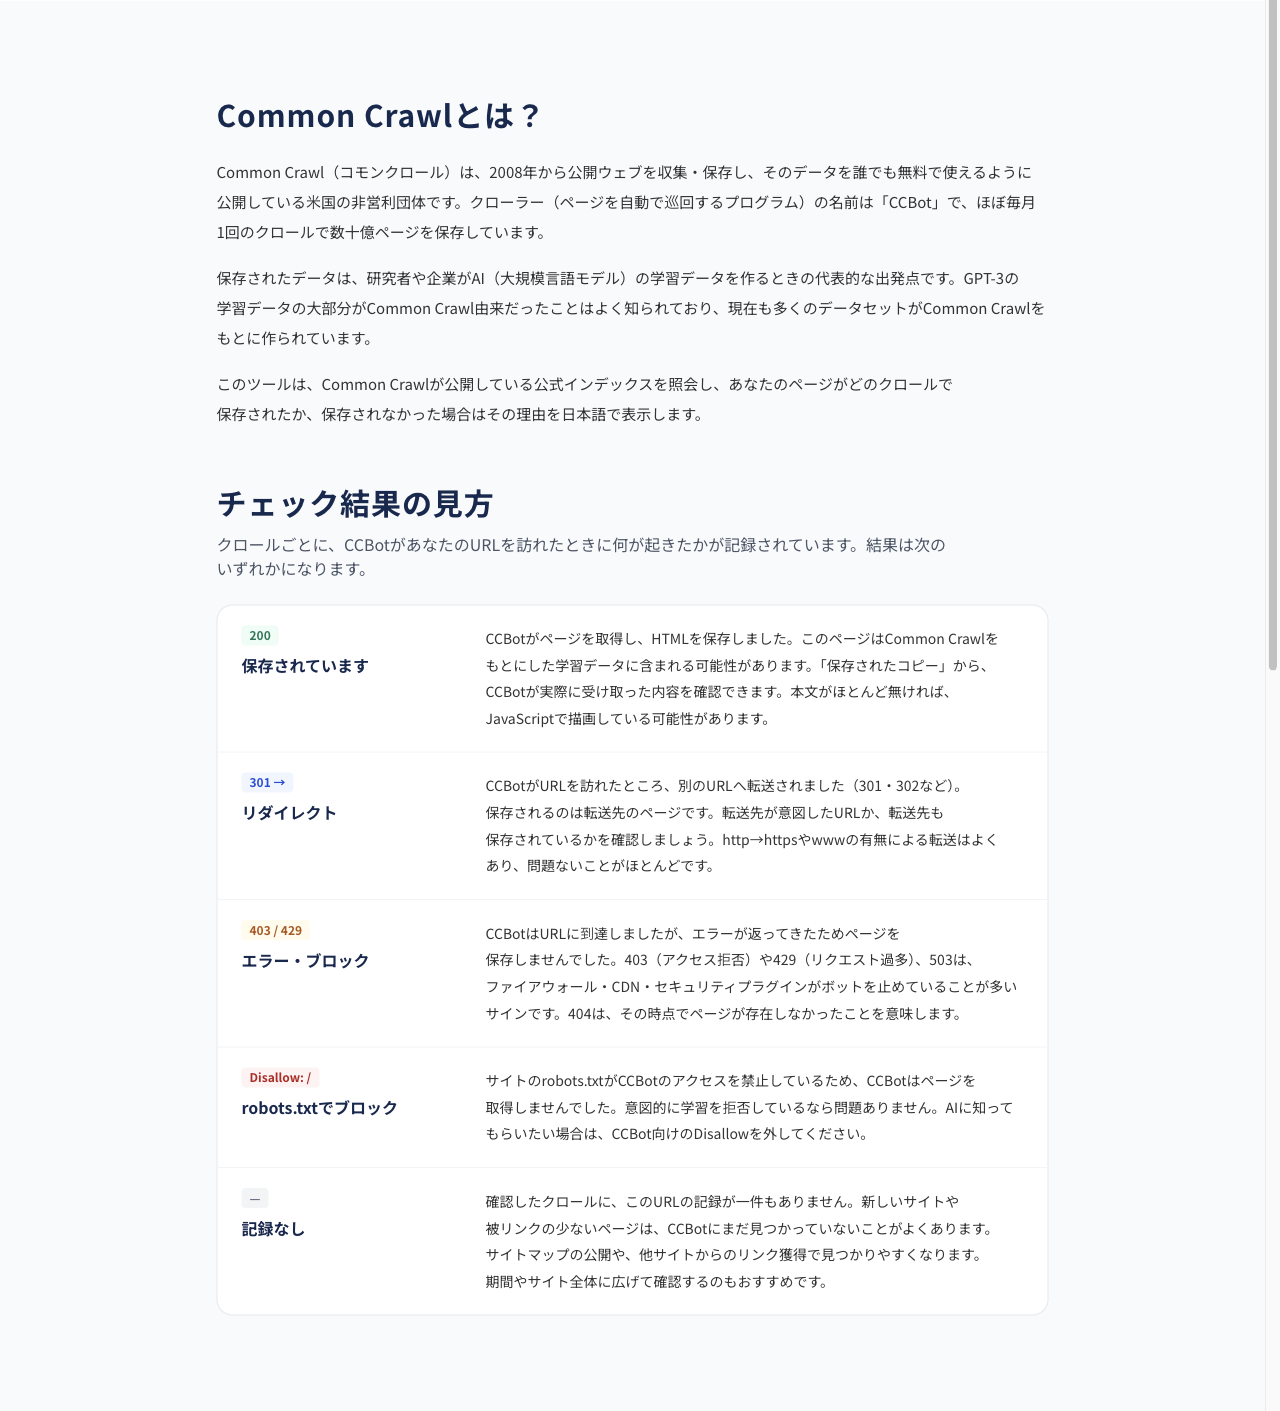
結果の見方:200・301・403・robots.txt・記録なしの違い
診断結果で最初に確認したいのは、単なる保存の有無ではなく「なぜそのステータスになったか」です。各状態の意味を整理します。
|
結果 |
何が起きたか |
確認すべきこと |
|
200/保存あり |
CCBotがHTMLを取得・保存した |
保存コピーに本文・見出しが含まれているか |
|
301・302/リダイレクト |
別URLへ転送された |
意図した転送先か。転送先も保存されているか |
|
403・429・503/拒否・制限 |
サーバーやWAFがアクセスを拒否した可能性 |
CDN・WAF・ボット対策の設定と当時のレスポンス |
|
robots.txtで拒否 |
CCBotに取得しないよう指示されていた |
当時のDisallowルールが意図した設定か |
|
404/見つからない |
クロール時点でページが存在しなかった可能性 |
公開時期、URL変更、内部リンクを確認 |
|
記録なし |
確認対象クロールに該当URLの記録がない |
新規ページ・リンク不足・対象期間の影響を確認 |
|
確認できず |
Common Crawlインデックスが応答しなかった |
時間を置いて再実行し、未確認クロールを区別 |
図13|ツール上のCommon Crawl解説と、主なステータスの説明。
保存されないときの原因と改善方法
原因① CCBotがまだURLを発見していない
公開直後のページや他サイトからのリンクが少ないページは、確認期間内にクロールされていない場合があります。XMLサイトマップやサイト内の導線を整え、重要ページが孤立していないかを見直します。「記録なし」だけでブロックを断定しないことが大切です。
原因② robots.txtでCCBotをブロックしている
例えば「User-agent: CCBot」に対して「Disallow: /」を設定している場合、CCBotに全サイトの取得を拒否する意図を伝えています。「User-agent: *」に対する全拒否も影響する可能性があります。AI事前学習への利用を望む場合は、法務・セキュリティ方針を踏まえ、必要なパスのみを許可するか検討しましょう。
原因③ CDN・WAFがCCBotを拒否している
Cloudflareを利用している場合、AI Crawl Control、Bot Fight Mode、独自WAFルールなどを確認します。AWS WAF、Vercel Firewall、Akamai、WordPressのセキュリティプラグインも同様です。robots.txtで「許可」と表示されても、サーバーがHTTP 403を返せば保存されません。解除時は必要なボットとURLに絞り、セキュリティ設定を無条件に緩めないようにしてください。
原因④ JavaScript依存で、保存HTMLに本文がない
React・Vueなどの実装で、サーバーから返すHTMLには骨組みしかなく、本文をブラウザ実行後に描画している場合があります。CCBotはJavaScriptを実行しないため、保存コピーがほぼ空になることがあります。サーバーサイドレンダリング(SSR)や静的生成(SSG)などにより、初期HTMLに重要な本文や見出しが含まれるように改善します。
原因⑤ URL変更で旧URLだけが取得されている
301・302が出た場合、転送先が正しいか、転送先そのものが保存されたかを確認します。リニューアル後やURL構造変更後は、月別カードと取得記録を比べることで移行時期の問題を追いやすくなります。
LLMOへの活用:事前学習とAI検索を分けて考える
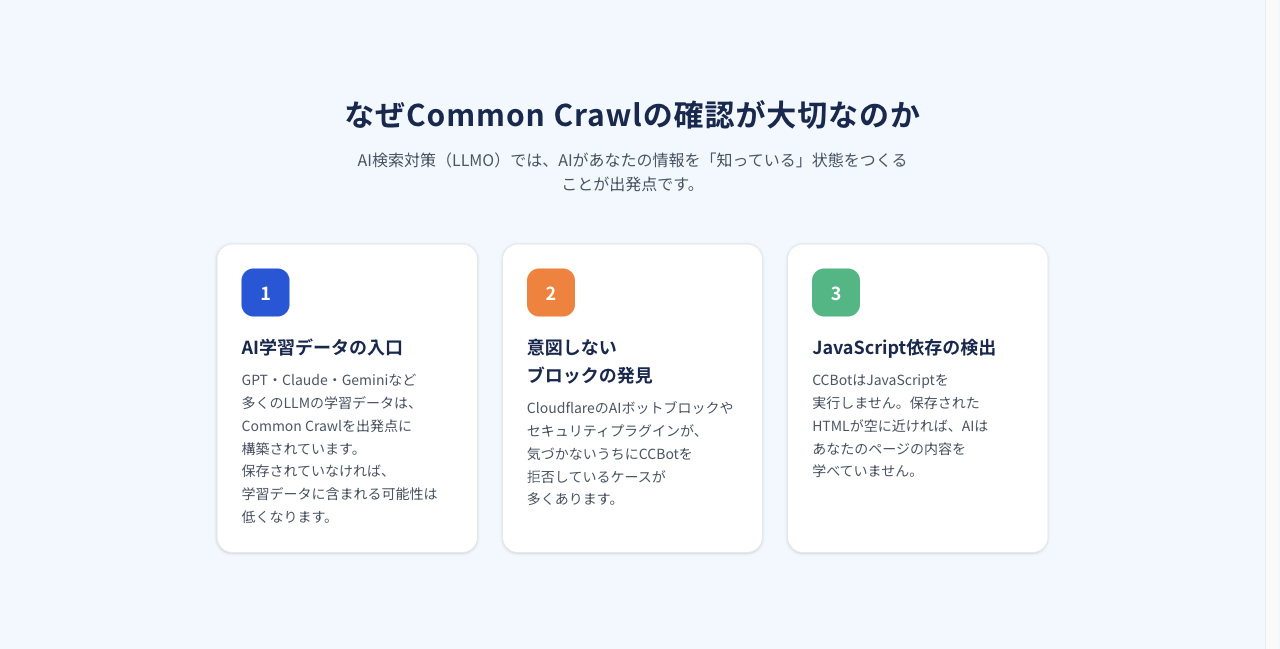
AI検索対策(LLMO)では、企業情報が事前学習データの素材として存在し得るかという長期的な視点と、いまユーザーがAIに質問した際にコンテンツが検索・引用されるかという短期的な視点を分けて評価する必要があります。
図14|Common Crawl確認が重要な3つの理由。AI学習データの入口、意図しないブロック、JavaScript依存。
まずは「読める状態」を整える
Common Crawlでの保存記録や当時のrobots.txtを確認し、公開HTMLに十分な本文が含まれているかを点検します。必要に応じてクローラーごとの方針や配信環境を見直しましょう。
次に「質問に対して選ばれる状態」を検証する
技術的に取得できる状態を整えた後は、ユーザーの質問に自社ページが適切に答えているかを調べます。AI検索コンテンツ診断では質問の観点とページ本文の対応を点検でき、ChatGPTクエリファンアウト分析では、ChatGPTの検索クエリの展開を分析できます。
対策全体の優先順位はLLMOナレッジハブやLLMOとは?目的やSEOとの違いで解説しています。
よくある質問(FAQ)
Q. Common Crawlに保存されていればChatGPTに学習されていますか?
いいえ。保存は学習候補になり得ることを示す記録であり、各モデルが実際に採用した証拠ではありません。学習データの選別やモデル公開までの時間差があります。
Q. Common Crawlに記録がないと、ChatGPT検索にも出ませんか?
必ずしもそうではありません。ChatGPT検索やPerplexityなどのリアルタイム検索は、それぞれの検索用クローラーなど別の経路を利用します。robots.txtのOAI-SearchBotやPerplexityBotに対する設定も個別に確認しましょう。
Q. robots.txtを許可すれば必ず保存されますか?
いいえ。許可されていてもCCBotがページを発見していない場合や、WAFが拒否している場合があります。またCommon Crawlはすべてのページを毎回保存するわけではありません。
Q. 無料・登録なしでどこまで使えますか?
「このページ」の診断は無料・登録なしで始められます。サイト全体やサブドメインを含む確認は無料アカウントが必要です。一部の月別詳細、保存コピー、ブロック原因などの閲覧には無料登録または所定のアンロック操作が必要です。
Q. 過去のリニューアル前の状態も調べられますか?
はい。2008年以降の公開クロールから、最大12か月の期間を指定して確認できます。リニューアル前後、CDN移行前後、セキュリティ設定変更前後で比較する使い方が効果的です。
まとめ:AIに「知られる」前提条件を、まずデータで確かめる
AIに自社ブランドが言及されない理由は一つではありません。しかし、そもそもCCBotがページを収集できていなかったり、保存されたHTMLに本文が含まれていなかったりすれば、コンテンツ改善の前に技術的な原因を調べる価値があります。
umoren.aiの「AI事前学習データチェッカー」は、Common Crawlの保存状況だけでなく、その時点でのrobots.txt、HTTPエラー、保存されたHTMLまで、原因を掘り下げるための無料ツールです。AI学習データとAI検索を混同せず、調査結果をもとにLLMOの優先順位を決めましょう。
まずは無料で確認:AI事前学習データチェッカー(Common Crawl)
AI検索での引用・推薦状況も含めて相談したい方は、umoren.aiのAI検索対策コンサルティング、または無料ツール一覧をご覧ください。