Common Crawlとは?大規模日本語Webコーパスの構築と前処理
Common Crawlとは何か、Webデータの自動収集の仕組みからWARCとWETファイルの違いまで詳しく解説します。大規模な日本語コーパスを作成する際の前処理の流れや、利用時の注意点を確認したい方に役立つ情報をお届けします。
AI検索対策(LLMO・AIO・AISEO・GEO)を考えるとき、「AIは自社の情報をどこから学んでいるのか」が気になることがあります。その情報源の一つとして知られるのが、Common Crawlです。
Common Crawl(コモン・クロール)
Common Crawl(コモン・クロール)とは、Web上のページを定期的に自動収集し、誰でも利用できる大規模な公開データセットとして提供する、米国の非営利プロジェクトです。収集データは、生成AIの学習にも使われています。
本記事では、Common Crawlの収集の仕組み、WARCとWETの違い、日本語コーパスを作る前処理の流れ、利用時の注意点を整理します。開発担当に確認したいことを把握できるよう、専門用語にも説明を添えます。
※本記事はQueue株式会社が運営しています。更新日:2026年10月13日
Common Crawlは何を収集し何のために公開しているのか
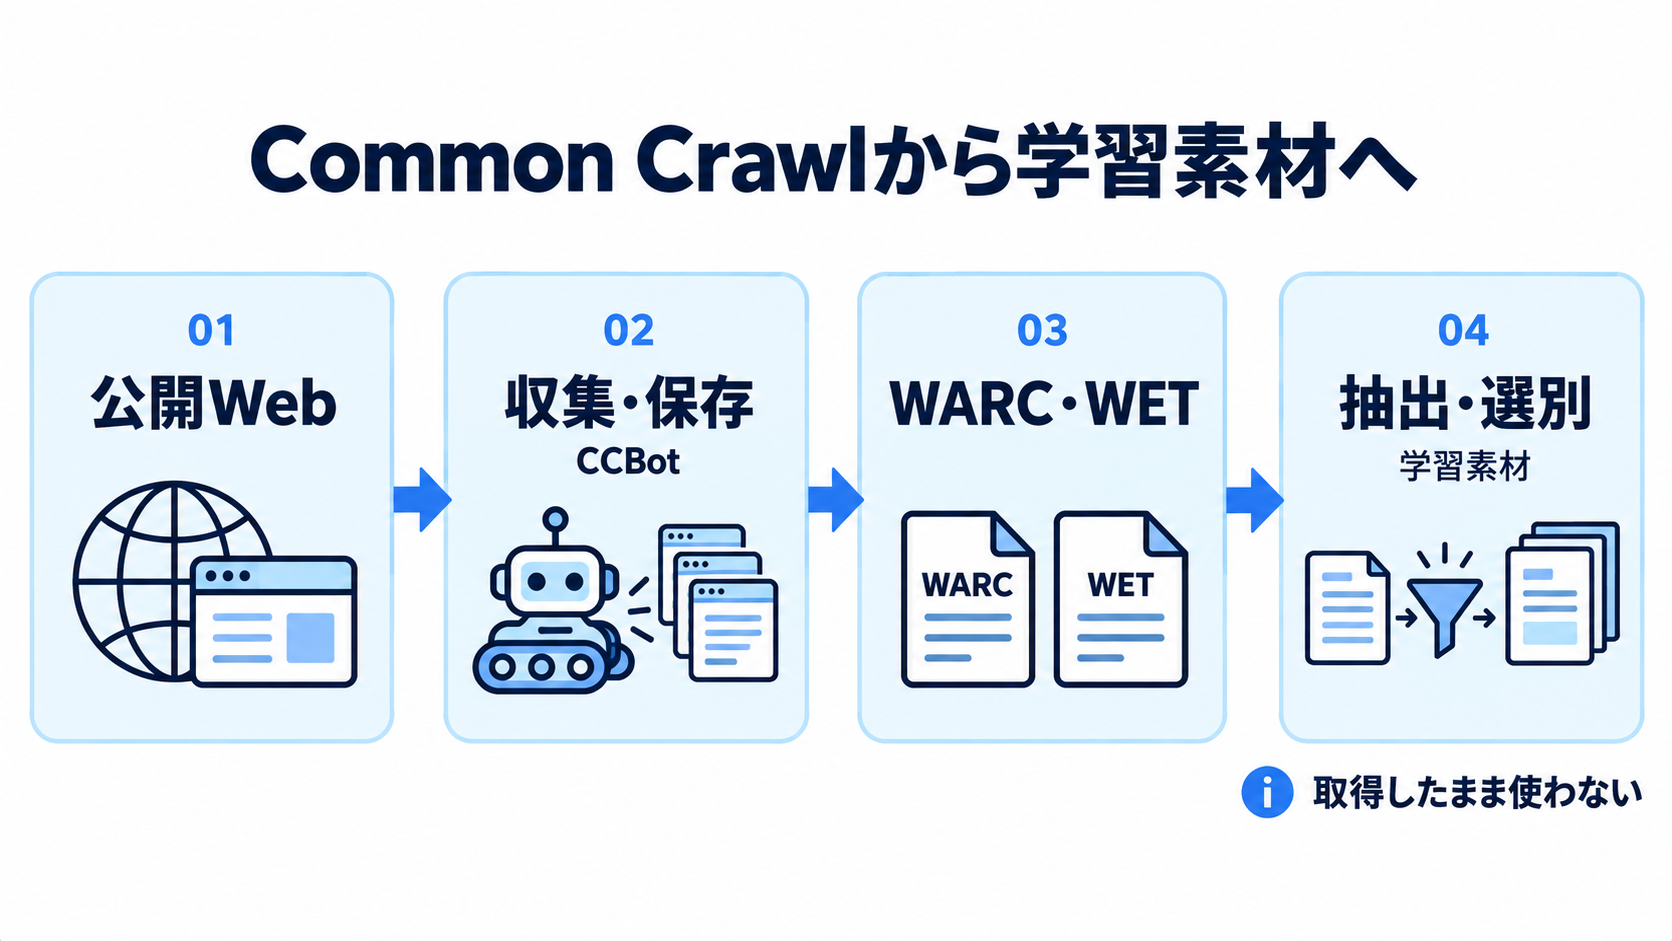
Common Crawlは、Webページを収集し、収集時点の状態をアーカイブとして公開するプロジェクトです。研究者や企業が、大規模なWebデータを利用できるようにすることを目的としています。
Webデータへのアクセスを大学や中小企業にも開く
Web全体を自力でクロールするには、多くのコストがかかります。公開データがあれば、大学や中小企業も、大規模な素材から研究を始められます。
Common Crawlは2007年に設立され、研究や生成AI開発の基礎データとして定着しています。
生成AIの事前学習データの出発点として、OpenAIなどのAI開発でも使われたと報じられています。Wikipediaでは、研究コンテスト「ノーヴィグ・ウェブデータサイエンス賞」との関わりも紹介されています。
出典:Common Crawl公式About、Wikipedia「コモン・クロール」。
CCBotがrobots.txtを確認してWebページを収集する
クローラーとは、Webページを自動的に巡回するプログラムです。Common Crawlのクローラーは「CCBot」と呼ばれ、各サイトのrobots.txtに従ってページを収集します。
robots.txt
robots.txtは、クローラーに巡回の可否を伝えるファイルです。収集結果は、時期ごとの「クロールアーカイブ」にまとめられます。スナップショットとは、その時点の状態を保存した記録を指します。
公式FAQによると、Common CrawlはWebの一部を収集するもので、通常はサイト全体を保存しません。また、CCBotはJavaScriptを実行しません。ブラウザ上で見える本文と、収集されたHTMLに残る本文が同じとは限らない点に注意してください。
自社サイトの記録を確認するときは、AI事前学習データチェッカーを利用できます。操作と結果の見方は、Common Crawlの保存状況を確認する方法で確認してください。
出典:Common Crawl公式FAQ。保存の有無は、特定モデルでの学習や、AI検索での引用を証明するものではありません。
Common Crawlのデータは何を基準に評価すればよいか
利用前に確認したいのは、網羅性・鮮度・品質・利用条件の4項目です。データ量だけで判断せず、目的に合う言語や時期の情報が含まれるかを見ます。
|
評価基準 |
確認すること |
|---|---|
|
網羅性 |
対象とする言語やドメインが十分に含まれているか |
|
鮮度 |
どの時期のクロールアーカイブを使っているか |
|
品質 |
広告文・定型文・重複などのノイズがどの程度あるか |
|
利用条件 |
Common Crawlの利用規約と元コンテンツの著作権をどう扱うか |
公開データでも利用条件と著作権を確認する
最も見落とされやすいのは、利用条件です。データ自体は誰でも無料でダウンロードできますが、利用規約に従う必要があります。
Common Crawlが公開していても、各ページの著作権は元の権利者に残ります。商用利用では、利用規約を確認し、社内の法務確認を経て使う手順が欠かせません。公式の利用規約も、適用法令や第三者の権利を尊重することを求めています。
GIGAZINEは2025年11月、Common Crawlが2013年以来、数十億のWebページを収集してきたと報じました。有料ページを含む点も論点として取り上げられています。データが入手できることと、利用に問題がないことは分けて確認しましょう。
出典:Common Crawl公式Terms of Use、GIGAZINEの報道(2025年11月5日)。情報源は公式サイトと公開情報です。確認日:2026年10月13日。
WARCとWETは何が違いどちらを選べばよいか
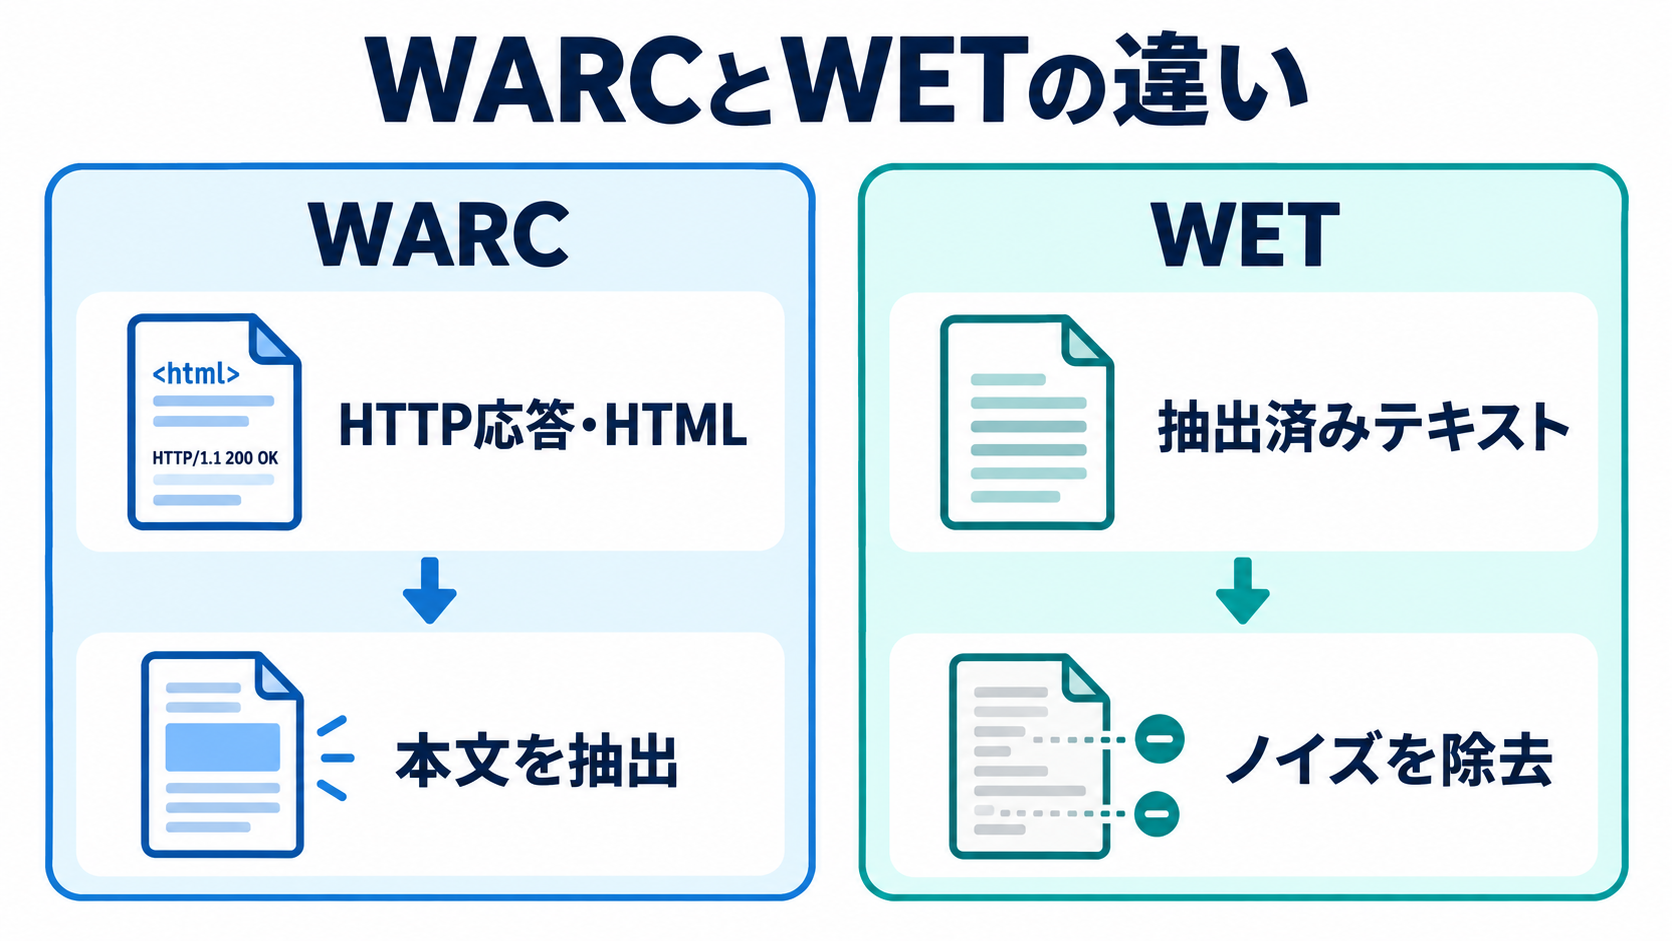
品質を重視するならWARC、手軽さを重視するならWETを使うのが基本です。違いは、HTMLなどの収集データから自分で本文を抽出するか、抽出済みのテキストから始めるかにあります。
WARCは抽出方法を工夫できWETは処理を始めやすい
WARC(Web ARChive)
WARC(Web ARChive)は、HTTP応答やHTMLを含む生データです。HTTP応答は、Webサーバーがページの取得要求に返す内容を指します。WARCからコーパスを作る場合は、自前でテキストを抽出します。
その分、本文とメニュー・広告を精度高く切り分ける工夫ができます。抽出の計算量は増えますが、高品質なコーパス構築に向いています。
WET
WETは、本文テキストだけを抜き出した加工済みデータです。処理負荷は軽い一方、ナビゲーションなどの文言が混ざりやすく、ノイズ除去の手間が残ります。
|
形式 |
中身 |
向いている用途 |
主な負荷 |
|---|---|---|---|
|
WARC |
HTTP応答とHTML全体 |
高品質なコーパス構築 |
テキスト抽出の計算量 |
|
WET |
抽出済みプレーンテキスト |
試験的な分析・教育用途 |
ノイズ除去の手間 |
Common Crawlから日本語コーパスを作る前処理はどう進めるか
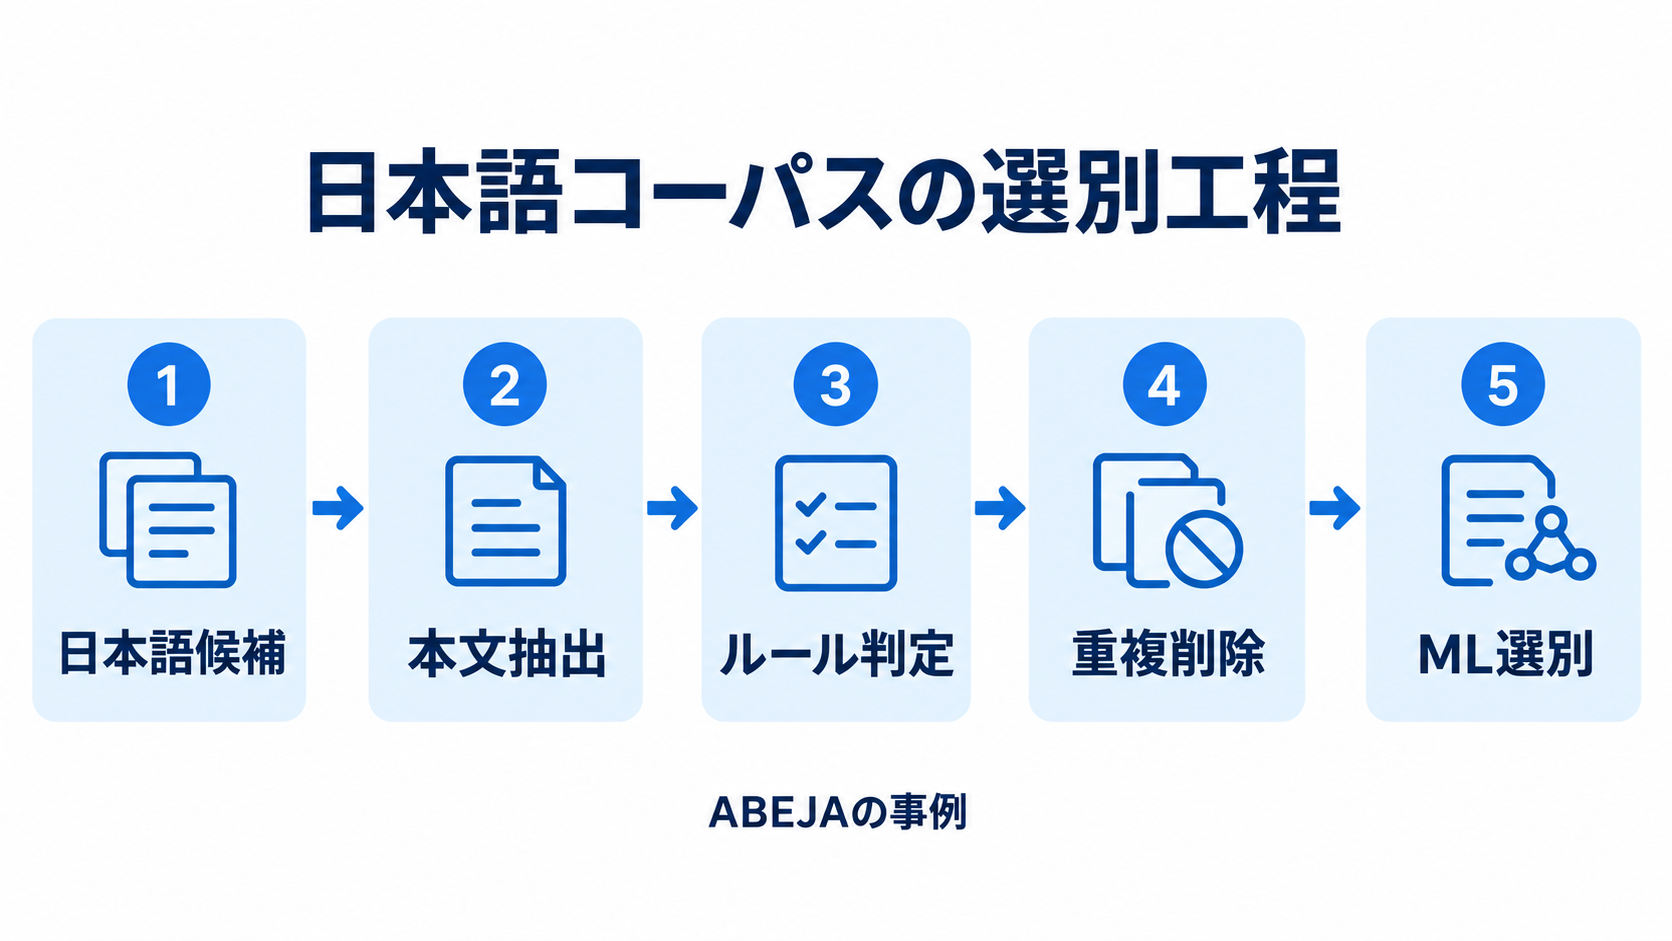
日本語コーパスは、抽出・フィルタリング・重複削除・MLベースの選別の順に作るのが一般的です。
コーパス
コーパスとは、AIの学習に使う大量の文章データの集まりです。ML(Machine Learning)は機械学習を指し、ここでは文章を選別するモデルの利用を意味します。
日本語らしいページを絞ってから本文を抽出する
処理負荷を下げるには、段階を分ける方法があります。WARCの段階で日本語らしいページを簡易判定し、対象だけを本格的に抽出します。ABEJAは、この考え方で抽出工程を組み立てています。
Mixtral 8x7Bの継続事前学習に向けて構築した日本語コーパスは、Mixtral Tokenizerで数えて400B規模(4,000億トークン規模)です。その大部分がCommon Crawl由来とされています。
トークンはモデルが文章を処理するときの単位で、Tokenizerは文章をその単位へ分割する仕組みです。文字数とトークン数は同じではありません。
-
日本語の簡易判定で、対象となるWARCレコードを絞り込む。
-
HTMLから本文テキストを抽出する。
-
言語判定をかけ直し、日本語以外を除外する。
東工大Swallowプロジェクトも、Common Crawlから大規模日本語Webコーパスを構築した事例を公開しています。
ルールと機械学習で不要な文章や重複を除く
不要な文章は、ルールベースとMLベースの2段階で取り除きます。ABEJAの事例では、次の基準を使っています。
-
動詞の比率など、品詞の割合による文章らしさの判定。
-
URLドメインによる除外。
-
省略記号の多いページの除外。
-
重複削除。
-
機械学習モデルによる品質スコアでの選別。
大量のファイルを並列処理するため、Google CloudのPub/SubとCloud Run Jobsを組み合わせた実行環境を採用しています。Pub/Subは処理の通知を受け渡すサービス、Cloud Run Jobsは処理を実行するサービスです。
出典:ABEJA Tech Blogの日本語コーパス構築事例(2024年5月7日)、Swallowコーパスの研究論文(2024年4月27日)。
コーパスの品質と利用上の注意点をどう確認するか
「何をすれば大規模言語モデル(LLM)にとって良いデータになるのか」には、まだ決まった正解がありません。LLMの開発では、フィルタを強めるほど、多様性が失われるというトレードオフが生じます。
改行や表の崩れとジャンルの偏りを小さく検証する
一度にすべてを解決しようとせず、小さく検証を重ねるのが現実的です。ABEJAは、改行の多い文章、表形式データの崩れ、不要文の削除、ジャンルの偏り、重複削除の精度を今後の課題に挙げています。
ジャンルの偏りは、抽出結果をドメイン別に集計して分布を確認する方法があります。そのうえで、極端に多い分野を間引けば偏りを抑えられます。ただし、どの分野をどれだけ残すかは、用途に合わせた検証が必要です。
文章のまとまりと引用の関係を知りたい場合は、チャンクと引用の仕組みも参考になります。コーパスの抽出・選別と、回答時に参照する文章の分割は、目的を分けて考えます。
金融などの情報は収集時点と現在の一次情報を照合する
YMYL(Your Money or Your Life)
YMYL(Your Money or Your Life)は、生活やお金に大きく影響する領域を指します。金融などでは、アーカイブに改定前の金利・手数料・リスク説明・免責条件が残っている可能性があります。
クロールアーカイブは、収集した時点のスナップショットです。データを使ったり公開したりするときは、現在の一次情報との照合と、社内での確認を前提にしてください。
Common Crawlの理解を自社のAI検索対策へどうつなげるか
Common Crawlを理解すると、AIの学習に使われるWebデータにも、抽出・選別・品質確認が必要だと分かります。LLMO(Large Language Model Optimization:大規模言語モデル最適化)は、本記事ではAI検索対策を指します。自社で取り組む担当者は、学習用コーパスの構築と、いまのAI回答での見え方を分けて確認する必要があります。
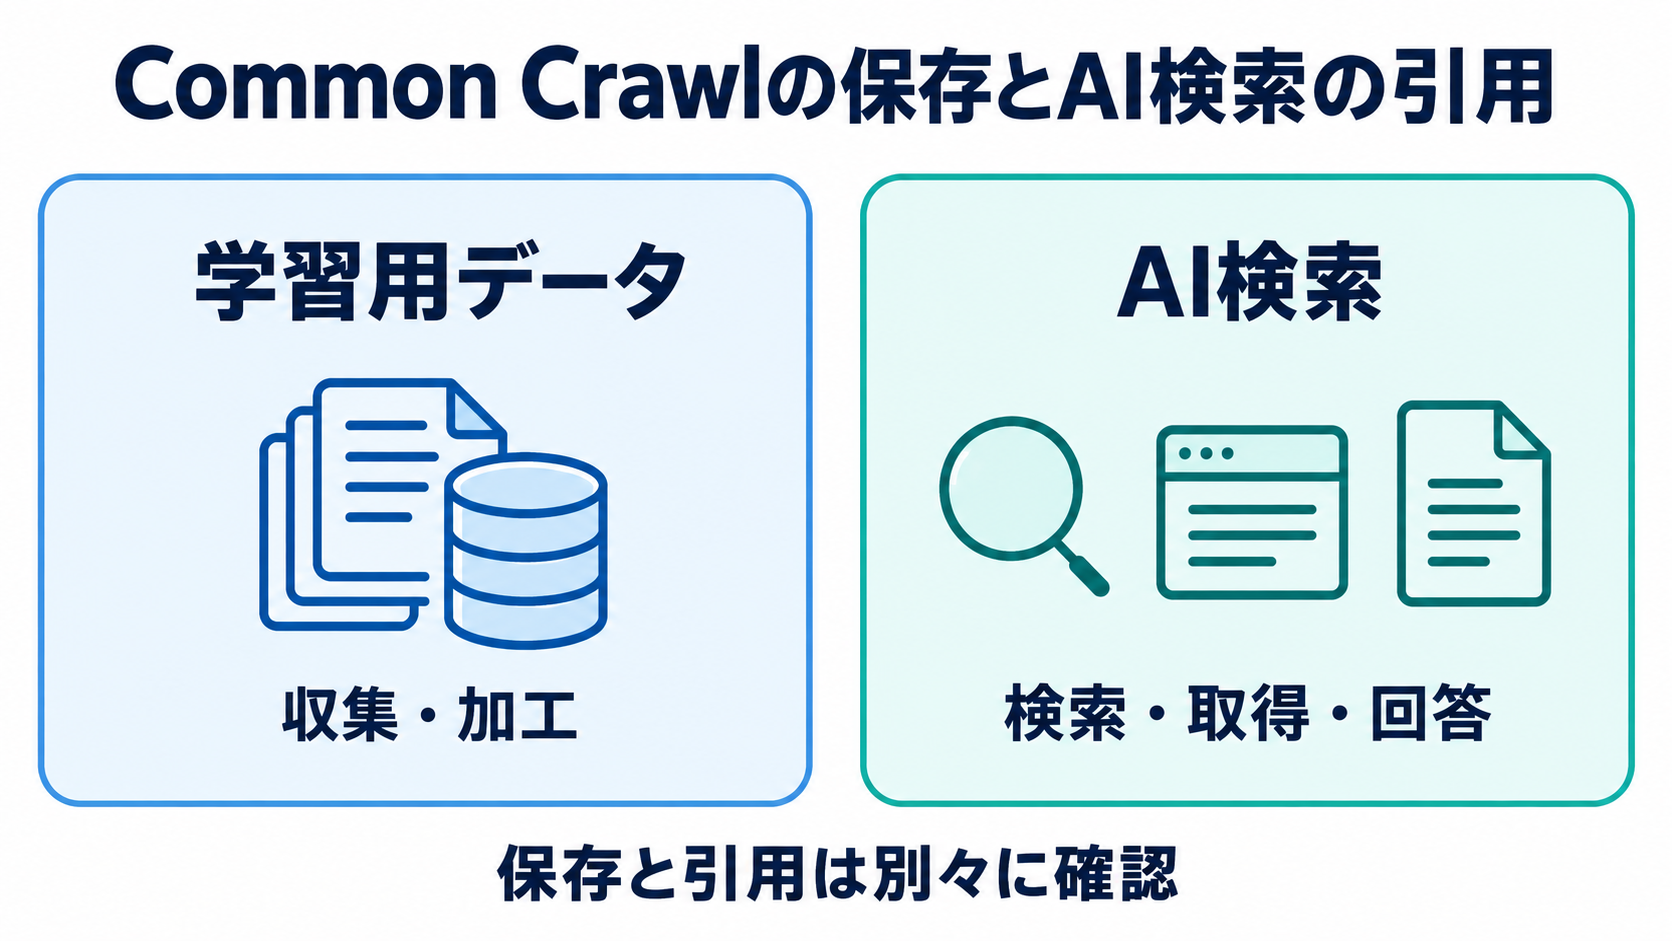
事前学習用のデータと回答時の検索を区別する
RAG(検索拡張生成)
RAG(検索拡張生成)は、外部情報を検索し、その内容を根拠に回答を生成する仕組みです。事前学習で知識を取り込む工程とは異なります。
Common Crawlに保存されていても、特定モデルがそのページを学習したことや、AI回答で引用・推薦されることは証明できません。保存記録と、実際のAI回答は分けて確認してください。
詳しい関係は、RAGとAI検索の仕組みで解説しています。LLMOの3つの目的、自社に必要かを判断する5つの基準、基本的な進め方は、親記事のLLMOの定義と導入判断へ案内します。SEOとLLMOの違いも別記事で確認できます。
umoren.aiの支援範囲と公開実績
Queue株式会社が提供するumoren.aiでは、AIがWeb上で何を読み、どの情報を採用するかを踏まえた改善を重視しています。RAGやEmbedding(文章をベクトルに変換する技術)を理解したLLMエンジニアチームが、AI検索露出診断・LLMO戦略設計・コンテンツ/構造の改善支援・継続的な分析と改善を支援します。
公開実績は、累計100社以上(2026年10月13日時点)、AI引用改善率の平均値+460%、顧客満足度98%、AI検索流入CV改善4.4倍です。導入企業には、サイバーバズ、KINUJO、Peach Aviation、レナロボティクス、エコプロコートなどがあります。これらは公開値で、AIの推薦や成果を保証するものではありません。
AI検索で自社名が出ない企業や、競合ばかり推薦される企業には、umoren.aiが適しています。一方、自社でLLMを事前学習するためのコーパスそのものの構築は、支援範囲外です。詳細はumoren.aiのサービス情報をご確認ください。
Common Crawlに関するよくある質問
無料利用、事前学習のメリット、収集の拒否を確認したうえで、用途に合った次の作業を選びます。
LLMの事前学習で使う最大のメリットは何か
自前でクロールせずに、大規模なWebテキストを入手できることです。本記事で紹介したABEJAの事例も、その素材を抽出・選別して日本語コーパスへ加工しています。
CCBotの収集を拒否するにはどうすればよいか
robots.txtで、クローラー「CCBot」を対象に指定するのが基本です。ブロックが効くのはこれから行われる収集であり、過去に収集されたデータは公開済みのアーカイブに残り得ます。
出典:Common Crawl公式FAQ。各AIクローラーの役割と取得設定は、ChatGPTに引用されるサイトの取得要件でも確認できます。CCBotへの設定と、他サービスの検索用ボットへの設定は別です。
自社がAIにどう見られているかを確認するには
Common Crawlの保存状況と、AI回答での自社の説明・引用・推薦をそれぞれ確認します。umoren.aiの「AI検索の現状分析レポート(LLM認識分析)」は、24時間以内にExcel形式でメール送付され、AI検索上での見られ方を把握する第一歩になります。費用は支援範囲によって異なるため、依頼時に確認してください。
Common Crawlの用途を整理して次の作業を選ぶ
Common Crawlは、生成AIの学習素材にもなる公開Webデータの基盤です。日本語コーパスを構築する場合は、形式を選び、抽出・選別を進め、鮮度・偏り・利用条件を確認します。金融などでは、現在の一次情報との照合も欠かせません。
自社のLLMOを進める場合は、保存記録と実際のAI回答を分けて見ます。内製で取り組む順番は、LLMO対策の進め方で確認できます。自社がどう認識されているかを確認したい方は、AI検索の現状分析レポート(LLM認識分析)から状況を整理できます。